ERP und Warenwirtschaft: das Zusammenspiel
Warenwirtschaft und ERP werden oft in einem Atemzug genannt – zu Recht, denn die Warenwirtschaft ist ein Kernbestandteil jedes ERP-Systems. Dieser Beitrag erklärt das Zusammenspiel und zeigt, welchen Vorteil die Integration bringt.
Die Warenwirtschaft als Herzstück des ERP
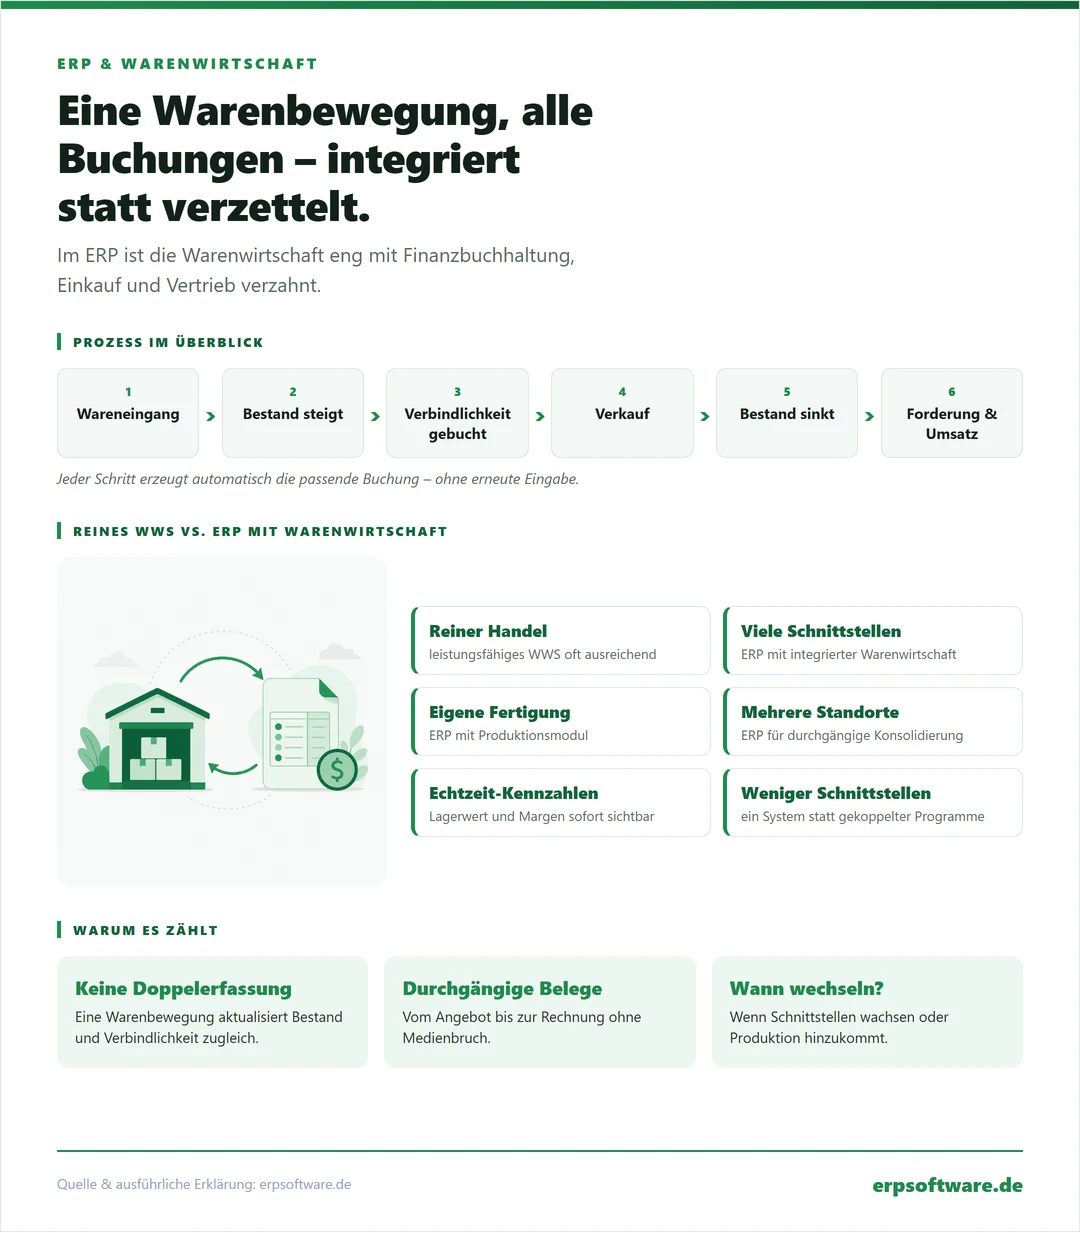
In den meisten Unternehmen beginnt die Digitalisierung bei der Ware: Bestände, Bestellungen, Aufträge. Genau hier setzt die Warenwirtschaft an. Im ERP-System ist sie kein Inselmodul, sondern eng mit Finanzbuchhaltung, Einkauf und Vertrieb verzahnt – jede Warenbewegung erzeugt automatisch die passenden Folgebuchungen.
Was die Integration konkret bringt
- Keine Doppelerfassung: Ein Wareneingang aktualisiert Bestand und Verbindlichkeiten zugleich.
- Durchgängige Belege: vom Angebot über Lieferschein bis zur Rechnung ohne Medienbruch.
- Aktuelle Zahlen: Lagerwert und Margen stehen in Echtzeit im Controlling.
- Weniger Schnittstellen: ein System statt mehrerer gekoppelter Programme.
Reines WWS vs. ERP mit Warenwirtschaft
Ein eigenständiges Warenwirtschaftssystem deckt den Warenfluss ab, benötigt für die Buchhaltung aber eine Schnittstelle. Das ERP integriert beides. Der Übergang lohnt sich, wenn die Zahl der Schnittstellen wächst, Auswertungen über Bereiche hinweg nötig werden oder Produktion ins Spiel kommt.
| Situation | Empfehlung |
|---|---|
| Reiner Handel, einfache Buchhaltung | leistungsfähiges WWS oft ausreichend |
| Viele Schnittstellen, wachsende Komplexität | ERP mit integrierter Warenwirtschaft |
| Eigene Fertigung / Produktion | ERP mit Produktionsmodul |
| Mehrere Standorte / Mandanten | ERP für durchgängige Konsolidierung |
Worauf bei der Auswahl achten?
Prüfen Sie, wie tief die Warenwirtschaft im ERP integriert ist und ob branchentypische Abläufe (z. B. Chargen, Seriennummern, Mehrlager) unterstützt werden. Den methodischen Weg beschreibt die ERP-Auswahl; einen Überblick zu Produkten bietet ERP-Programme.
Vom Beleg zur Buchung: der integrierte Datenfluss
Der eigentliche Mehrwert der Verbindung von ERP und Warenwirtschaft zeigt sich im automatischen Datenfluss zwischen Ware und Finanzen. Jede Warenbewegung hat eine wertmäßige Seite, die in der Buchhaltung abgebildet werden muss. Geht Ware ein, entsteht zugleich eine Verbindlichkeit gegenüber dem Lieferanten und der Lagerwert steigt; wird Ware verkauft, sinkt der Bestand und es entsteht eine Forderung samt Umsatz. In getrennten Systemen müssten diese Vorgänge doppelt erfasst und regelmäßig abgeglichen werden – fehleranfällig und zeitraubend. Im integrierten ERP geschieht die Verbuchung automatisch im Hintergrund, sobald der warenwirtschaftliche Beleg entsteht.
Dieser durchgängige Fluss hat handfeste Vorteile. Der Lagerwert ist jederzeit korrekt in der Bilanz abgebildet, ohne manuelle Inventurbuchungen. Offene Posten auf der Einkaufs- und Verkaufsseite entstehen automatisch und lassen sich lückenlos nachverfolgen. Und das Controlling kann Margen bis auf einzelne Artikel oder Aufträge auswerten, weil Mengen und Werte aus derselben Quelle stammen. Gerade für wachsende Unternehmen, bei denen die Zahl der Belege stark zunimmt, wird diese Automatik schnell zum entscheidenden Effizienzfaktor.
Migration vom reinen WWS zum ERP
Der Umstieg von einem eigenständigen Warenwirtschaftssystem auf ein integriertes ERP ist ein Projekt mit Vorlauf. Stammdaten wie Artikel, Lieferanten und Kunden müssen bereinigt und übernommen werden, Prozesse werden neu gedacht und Schnittstellen abgelöst. Der Aufwand lohnt sich, sobald die Nachteile der getrennten Systeme – viele Schnittstellen, doppelte Pflege, fehlende Gesamtsicht – die Vorteile überwiegen. Eine strukturierte Auswahl und Einführung sind dabei dieselben Erfolgsfaktoren wie bei jedem ERP-Projekt.
Ein durchgängiger Prozess in der Praxis
Wie eng Warenwirtschaft und ERP zusammenwirken, lässt sich an einem typischen Ablauf zeigen. Ein Kunde bestellt mehrere Artikel. Das System prüft die Verfügbarkeit, reserviert die vorhandene Ware und erzeugt für fehlende Positionen einen Bestellvorschlag an den Einkauf. Trifft die nachbestellte Ware ein, bucht das System den Wareneingang, erhöht den Lagerbestand und erfasst zugleich die Verbindlichkeit gegenüber dem Lieferanten in der Buchhaltung. Bei der Auslieferung entstehen Lieferschein und Rechnung aus denselben Daten, der Bestand sinkt, und die Forderung samt Umsatz wird automatisch verbucht.
In einem integrierten ERP läuft diese gesamte Kette ohne erneute Dateneingabe und ohne Abstimmung zwischen getrennten Programmen. Genau hier liegt der Effizienzgewinn gegenüber einer eigenständigen Warenwirtschaft mit angebundener Buchhaltung: Jeder Schritt erzeugt automatisch den nächsten und die passende Buchung.
Kennzahlen aus dem integrierten System
Weil Mengen und Werte aus einer gemeinsamen Quelle stammen, liefert das integrierte System belastbare Kennzahlen auf Knopfdruck. Der Lagerumschlag zeigt, wie schnell Kapital im Lager gebunden und wieder freigesetzt wird. Deckungsbeitrags- und Margenauswertungen reichen bis auf einzelne Artikel oder Aufträge hinunter. Offene Posten auf Einkaufs- und Verkaufsseite sind jederzeit aktuell. Diese Transparenz ermöglicht eine fundierte Steuerung: Überbestände lassen sich abbauen, unrentable Artikel erkennen und Liquiditätsengpässe frühzeitig absehen. Eine eigenständige Warenwirtschaft kann solche bereichsübergreifenden Auswertungen nur eingeschränkt liefern, weil ihr die finanzielle Sicht fehlt. Mit wachsender Komplexität wird dieser Vorteil der Integration zum entscheidenden Argument für ein vollwertiges ERP.
Mehrere Lager, Filialen und Mandanten
Mit wachsender Unternehmensgröße steigt die Komplexität der Warenwirtschaft. Statt eines einzelnen Lagers sind oft mehrere Standorte, Filialen oder sogar rechtlich getrennte Gesellschaften zu verwalten. Ein integriertes ERP-System spielt hier seine Stärke aus: Es führt die Bestände aller Lager zentral, ermöglicht Umlagerungen zwischen Standorten und zeigt jederzeit, wo welche Ware verfügbar ist. So lässt sich ein Kundenauftrag aus dem günstigsten oder nächstgelegenen Lager bedienen.
Bei mehreren rechtlichen Einheiten kommt die Mandantenfähigkeit ins Spiel: Jede Gesellschaft wird getrennt geführt, doch lassen sich Bestände, Einkäufe und Auswertungen über die Grenzen hinweg konsolidieren. Diese Gesamtsicht ist mit getrennten Einzelsystemen kaum zu erreichen, weil jede Verbindung über fehleranfällige Schnittstellen liefe. Für filialisierte Händler und Unternehmensgruppen ist die zentrale, integrierte Warenwirtschaft daher oft das ausschlaggebende Argument für ein vollwertiges ERP. Wer eine solche Struktur plant oder bereits betreibt, sollte bei der Auswahl gezielt auf die Unterstützung mehrerer Lager, Filialen und Mandanten achten, da sich diese Fähigkeiten nachträglich nur schwer ergänzen lassen.
Echtzeit-Transparenz als Steuerungsvorteil
Der vielleicht größte Vorteil der Integration von Warenwirtschaft und ERP ist die Transparenz in Echtzeit. Weil jede Warenbewegung sofort die zugehörigen Buchungen und Kennzahlen aktualisiert, hat die Unternehmensführung jederzeit ein aktuelles Bild von Beständen, Umsätzen, offenen Posten und Margen. Diese unmittelbare Sicht ermöglicht schnelle, fundierte Entscheidungen – etwa bei der Disposition, der Preisgestaltung oder der Liquiditätsplanung. In getrennten Systemen dagegen liegen die nötigen Zahlen verstreut vor und müssen erst mühsam zusammengeführt werden, oft mit zeitlichem Verzug. Gerade in dynamischen Marktsituationen kann dieser Unterschied entscheidend sein. Wer auf verlässliche Echtzeitdaten zugreifen kann, reagiert schneller auf Chancen und Risiken. Die integrierte Lösung wird so vom reinen Abwicklungswerkzeug zum aktiven Instrument der Unternehmenssteuerung.
Warenwirtschaft als Teil des ERP
In einem ERP-System ist die Warenwirtschaft kein isoliertes Programm, sondern ein eng verzahntes Modul. Der entscheidende Unterschied zu einer eigenständigen Warenwirtschaft: Jeder Lager- und Verkaufsvorgang erzeugt automatisch die passenden Buchungen in der Finanzbuchhaltung und steht sofort in Controlling und Auswertungen zur Verfügung. Ware, Beleg und Buchung sind ein durchgängiger Vorgang statt drei getrennter Schritte.
Standalone-Warenwirtschaft vs. ERP-integriert
| Kriterium | Standalone-WWS | ERP-integrierte Warenwirtschaft |
|---|---|---|
| Finanzbuchhaltung | separate Software, Schnittstelle nötig | automatisch mitgebucht |
| Auswertungen | nur Warendaten | waren- und finanzübergreifend |
| Datenpflege | teils doppelt | einmal, zentral |
| Einführung | schlanker | umfangreicher, dafür durchgängig |
Das Zusammenspiel mit anderen Modulen
Die Stärke der ERP-Warenwirtschaft liegt in den Verbindungen zu den Nachbarbereichen:
- Finanzbuchhaltung: Wareneingang und Verkauf erzeugen Buchungen automatisch
- CRM/Vertrieb: Kundenhistorie, Angebote und Aufträge in einem System
- Einkauf: Bedarfe lösen Bestellvorschläge aus
- Produktion: Materialentnahmen und Fertigmeldungen wirken auf den Bestand
- Versand: Lieferscheine und Versandlabels aus demselben Vorgang
Wann reicht ein WWS, wann braucht es ERP?
ERP-Warenwirtschaft sinnvoll, wenn …
- Buchhaltung und Lager zusammenwachsen sollen
- mehrere Bereiche dieselben Daten brauchen
- Auswertungen finanzübergreifend sein müssen
- das Unternehmen wächst und skaliert
Eigenständiges WWS reicht, wenn …
- der Fokus klar auf Handel/Lager liegt
- die Buchhaltung extern (Steuerberater) läuft
- eine schlanke, schnelle Lösung gefragt ist
- das Budget begrenzt ist
Den Überblick über ERP gewinnen
Sie überlegen, Warenwirtschaft und Buchhaltung in einem System zu vereinen? Verstehen Sie zuerst, was ein ERP-System grundsätzlich leistet.
ERP-System erklärtDatenintegrität ohne Doppelerfassung: Warum integrierte Warenwirtschaft Schnittstellen-Abgleiche überflüssig macht
Die wirtschaftliche Leistung einer Warenwirtschaft entscheidet sich nicht allein an ihren Funktionen, sondern an der Frage, wo ihre Daten leben. Ein Artikelstamm, ein Lieferantenkonto oder eine Preisliste ist nur dann verlässlich, wenn er an genau einer Stelle gepflegt wird und überall denselben Stand zeigt. Genau hier trennt sich die integrierte Warenwirtschaft, die als Modul auf der gemeinsamen Datenbasis eines ERP-Systems aufsetzt, von der gekoppelten Welt aus eigenständigen Standalone-Systemen, die ihre Bestände über Schnittstellen miteinander abgleichen müssen. Dieser Abschnitt behandelt Datenkonsistenz ausdrücklich als Architekturmerkmal, nicht als Funktion: Es geht darum, ob redundante Datensätze überhaupt entstehen und synchronisiert werden müssen oder ob die Frage der Synchronität durch das Datenmodell von vornherein entfällt. Die buchungstechnische Verzahnung von Lager und Finanzbuchhaltung sowie die Echtzeit-Verfügbarkeit behandeln andere Abschnitte dieser Seite; hier steht ausschließlich die geteilte Datenbasis und ihre referentielle Integrität im Mittelpunkt.
Das Grundprinzip: eine Datenbasis statt synchronisierter Kopien
In einer integrierten Warenwirtschaft existiert ein Artikel genau einmal. Der Datensatz mit seiner Nummer, Bezeichnung, Mengeneinheit, Klassifizierung und seinen Preiskonditionen liegt in einer einzigen Tabelle der gemeinsamen Datenbank. Wenn der Einkauf eine Bestellung erfasst, der Vertrieb ein Angebot schreibt, das Lager eine Buchung vornimmt und die Buchhaltung eine Rechnung prüft, greifen alle vier auf denselben physischen Datensatz zu. Es gibt keine Kopie im Vertriebssystem, keine gespiegelte Variante im Lagerverwaltungssystem und keine dritte Fassung im Einkaufstool. Dasselbe gilt für den Lieferanten- und den Kundenstamm: Eine Adressänderung, eine neue Bankverbindung oder eine geänderte Zahlungskondition wird einmal erfasst und ist im selben Moment für jeden Geschäftsvorfall gültig, der diesen Partner referenziert.
Im gekoppelten Modell ist die Lage grundlegend anders. Hier betreibt jedes Standalone-System seine eigene Datenhaltung. Das Warenwirtschaftssystem führt einen eigenen Artikelstamm, das Finanzsystem einen weiteren, das Vertriebs- oder Shopsystem einen dritten. Damit dieselben Artikel in allen Systemen erscheinen, müssen die Datensätze repliziert werden: Anlage und Pflege geschehen in einem führenden System, von dort werden die Daten über Schnittstellen in die übrigen Systeme kopiert. Aus einem logischen Artikel werden so mehrere physische Datensätze, die fortan auseinanderlaufen können. Der entscheidende Unterschied liegt also nicht im Funktionsumfang, sondern in der Anzahl der Wahrheiten: Das integrierte Modell kennt eine, das gekoppelte Modell so viele, wie es Systeme gibt. Wer eine Warenwirtschaftssoftware bewertet, sollte diese Frage vor allen Funktionslisten klären, weil sie alle nachgelagerten Konsistenzprobleme determiniert.
Referentielle Integrität: warum die Datenbank Inkonsistenz verhindert
Der eigentliche Hebel des integrierten Modells ist die referentielle Integrität, ein Konzept aus der relationalen Datenbanktheorie. Es besagt vereinfacht: Ein Datensatz darf nur auf einen anderen verweisen, der tatsächlich existiert. Eine Lagerbuchung verweist über einen Fremdschlüssel auf eine Artikelnummer, eine Bestellung auf einen Lieferanten, ein Auftrag auf einen Kunden. Die Datenbank stellt durch hinterlegte Beziehungen sicher, dass diese Verweise nie ins Leere zeigen. Es ist technisch ausgeschlossen, eine Lagerbewegung für einen Artikel zu buchen, den es im Stamm nicht gibt, oder eine Bestellung an einen gelöschten Lieferanten zu richten. Die Konsistenz ist damit nicht eine Frage der Disziplin der Anwender oder der Sorgfalt der Abgleichroutine, sondern eine vom Datenmodell erzwungene Eigenschaft.
Hinzu kommt die Transaktionssicherheit: Eine zusammenhängende Operation, etwa eine Lagerbuchung mit gleichzeitiger Bestandsfortschreibung und Reservierungsauflösung, wird als eine einzige Transaktion behandelt. Sie wird entweder vollständig oder gar nicht wirksam. Es kann keinen Zustand geben, in dem die Bestandsmenge bereits reduziert, die zugehörige Bewegung aber noch nicht verbucht ist. Im gekoppelten Modell existiert diese Garantie über Systemgrenzen hinweg nicht. Eine Schnittstelle überträgt Daten zwischen zwei Datenbanken, die voneinander nichts wissen; sie kann eine Übertragung nur anstoßen, bestätigen oder fehlschlagen lassen, aber sie kann keine systemübergreifende Transaktion erzwingen. Fällt die Übertragung in der Mitte aus, ist System A bereits fortgeschrieben, System B noch nicht – ein Zustand, den im integrierten Modell die Datenbank von vornherein verbietet. Die referentielle Integrität ist damit das architektonische Gegenstück zum Abgleich: Sie macht ihn überflüssig, weil sie das Auseinanderlaufen unmöglich macht, statt es nachträglich zu korrigieren.
Der Mapping- und Abgleich-Overhead im gekoppelten Modell
Sobald derselbe Artikel in mehreren Systemen geführt wird, entsteht ein dauerhafter Verwaltungsaufwand, den das integrierte Modell schlicht nicht kennt. Im Zentrum steht das Mapping: Die Systeme verwenden in aller Regel nicht dieselben Schlüssel. Im Warenwirtschaftssystem heißt ein Artikel vielleicht „A-10042“, im Shopsystem trägt er eine eigene interne ID, im Finanzsystem eine Sachkonto- oder Erlösgruppenzuordnung. Damit eine Bestellmenge oder ein Verkaufsbeleg korrekt zugeordnet wird, muss eine Übersetzungstabelle pflegen, welcher Schlüssel im einen System welchem Schlüssel im anderen entspricht. Diese Mapping-Tabelle ist selbst ein Datenbestand, der gepflegt, versioniert und bei jeder Neuanlage oder Umnummerierung nachgezogen werden muss. Sie ist eine zusätzliche Fehlerquelle, die im integrierten Modell ersatzlos entfällt, weil dort ein einziger Schlüssel für alle Module gilt.
Auf das Mapping setzt der Synchronisationsprozess auf, der die eigentlichen Werte – Bestände, Preise, Stammdatenänderungen – zwischen den Systemen abgleicht. Dieser Prozess ist nie kostenlos: Er muss eingerichtet, überwacht, bei Ausfällen neu gestartet und bei jeder Schnittstellenänderung angepasst werden. Er erzeugt einen eigenen Betriebsaufwand, der mit jeder zusätzlichen Kopplung wächst. Vor allem aber führt er eine ganze Klasse von Fehlern ein, die in einer einheitlichen Datenbasis konstruktiv ausgeschlossen sind.
Die typischen Fehlerquellen synchronisierter Stammdaten
Wo Daten repliziert und abgeglichen werden, treten bestimmte Konsistenzprobleme regelmäßig auf. Sie sind keine Anwenderfehler, sondern strukturelle Folgen der verteilten Datenhaltung.
Synchronisationslatenz. Jeder Abgleich braucht Zeit. Erfolgt die Synchronisation in festen Intervallen – stündlich, nächtlich, in Batch-Läufen –, dann existiert zwischen zwei Läufen ein Zeitfenster, in dem die Systeme bewusst Unterschiedliches anzeigen. Ein im Shop verkaufter Artikel ist im Warenwirtschaftssystem erst nach dem nächsten Lauf als Abgang sichtbar; eine im Einkauf erfasste Preisänderung erreicht den Vertrieb mit Verzögerung. Selbst event-getriebene Schnittstellen, die nahezu in Echtzeit übertragen, kennen eine Restlatenz und können bei Lastspitzen Rückstau bilden. Im integrierten Modell ist die Latenz definitionsgemäß null, weil es nur einen Wert gibt, der gelesen wird – es gibt kein zweites System, das hinterherhinken könnte.
Dubletten. Werden Stammdaten in mehreren Systemen angelegt oder läuft ein Abgleich fehlerhaft, entstehen doppelte Datensätze: derselbe Lieferant zweimal mit leicht abweichender Schreibweise, derselbe Artikel unter zwei Nummern. Dubletten zersplittern die Historie – Umsätze, Bestände und Bewegungen verteilen sich auf mehrere Datensätze und ergeben in Summe ein falsches Bild. Ihre Bereinigung ist aufwendig und riskant, weil bereits verknüpfte Belege umgehängt werden müssen. Die referentielle Integrität einer geteilten Datenbasis erschwert Dubletten zwar nicht automatisch, aber sie entzieht ihnen die häufigste Ursache, weil es keine parallelen Anlageorte und keinen Replikationskanal mehr gibt, über den eine Dublette entstehen könnte.
Divergierende Mengeneinheiten. Ein klassischer und besonders teurer Fehler entsteht, wenn Systeme dieselbe Ware in unterschiedlichen Einheiten führen. Das eine System rechnet in Stück, das andere in Verpackungseinheiten, ein drittes in Kilogramm. Überträgt die Schnittstelle eine Menge ohne korrekte Umrechnung, multiplizieren oder dividieren sich Bestände und Werte um den Umrechnungsfaktor. Im integrierten Modell sind Basismengeneinheit und Umrechnungsfaktoren Teil des einen Artikelstamms; jede Buchung rechnet gegen dieselbe hinterlegte Logik, sodass eine systemübergreifende Fehlinterpretation gar nicht entstehen kann.
Divergierende Preislisten. Preise und Konditionen sind besonders änderungsintensiv und damit besonders abgleichanfällig. Eine im führenden System hinterlegte Staffel, ein Aktionspreis oder eine kundenindividuelle Kondition muss in jedes nachgelagerte System gespiegelt werden. Verzögert sich der Abgleich oder schlägt er fehl, verkauft der Vertrieb zu veralteten Preisen, oder die Rechnung weicht vom Angebot ab. In der integrierten Warenwirtschaft liegt die Preisfindung an einer Stelle; alle Belege ziehen ihre Konditionen aus derselben Quelle, womit Angebot, Auftrag und Rechnung zwangsläufig denselben Preis sehen.
Kernunterscheidung: Im gekoppelten Modell muss Konsistenz hergestellt werden – durch Mapping, Synchronisation und Konfliktbehandlung. Im integrierten Modell ist Konsistenz vorausgesetzt, weil es nur einen Datensatz gibt, der gar nicht erst inkonsistent werden kann. Der Abgleich wird nicht verbessert, sondern strukturell überflüssig.
Zwei Architekturen im direkten Vergleich
Die folgende Gegenüberstellung führt beide Welten an denselben Konsistenzkriterien zusammen. Links steht das gekoppelte Modell aus eigenständigem Warenwirtschaftssystem und separatem ERP, verbunden über Schnittstellen; rechts die in das ERP integrierte Warenwirtschaft mit einer zentralen Stammdaten-Datenbank, auf die alle Module direkt zugreifen.
Standalone-WWS + ERP gekoppelt
- Mehrere physische Artikel-, Lieferanten- und Kundenstämme je System
- Mapping-Tabelle übersetzt unterschiedliche Schlüssel zwischen den Systemen
- Synchronisation per Schnittstelle (Batch oder Event), mit Restlatenz
- Konsistenz wird nachträglich hergestellt und überwacht
- Konfliktrisiko: Dubletten durch parallele Anlage
- Konfliktrisiko: divergierende Mengeneinheiten ohne korrekte Umrechnung
- Konfliktrisiko: veraltete oder abweichende Preislisten
- Keine systemübergreifende Transaktion: Teilfortschreibung bei Abbruch möglich
- Betriebsaufwand wächst mit jeder zusätzlichen Kopplung
Integrierte Warenwirtschaft
- Ein einziger Stammdatensatz je Artikel, Lieferant und Kunde
- Ein gemeinsamer Schlüssel für alle Module – kein Mapping nötig
- Kein Abgleich: alle Module lesen denselben Datensatz direkt
- Konsistenz ist durch das Datenmodell vorausgesetzt
- Dubletten ohne Replikationskanal und parallele Anlageorte unwahrscheinlich
- Mengeneinheit und Umrechnung einmal hinterlegt, für alle verbindlich
- Preisfindung an einer Stelle: Angebot, Auftrag und Rechnung identisch
- Transaktionssicherheit: vollständige Buchung oder gar keine
- Kein zusätzlicher Betriebsaufwand für Schnittstellen
Die Gegenüberstellung macht das eigentliche Argument sichtbar: Es geht nicht darum, dass das integrierte Modell die Schnittstelle „besser“ betreibt, sondern dass es die Schnittstelle für die Stammdaten gar nicht braucht. Jede Zeile auf der linken Seite beschreibt einen Aufwand oder ein Risiko, das auf der rechten Seite nicht reduziert, sondern strukturell entfernt ist. Diese Differenz ist ein zentrales Kriterium bei der Auswahl eines ERP-Systems, weil sie nicht nachträglich behoben werden kann – sie ergibt sich aus der Architektur, für die man sich entscheidet.
Single Source of Truth als Architekturprinzip
Der Begriff, der dieses Modell zusammenfasst, ist die Single Source of Truth – die einzige Quelle der Wahrheit. Gemeint ist, dass es für jeden Sachverhalt genau einen autoritativen Ort gibt, an dem der gültige Wert steht. Jede Anzeige, jeder Beleg, jede Auswertung liest aus dieser Quelle; es gibt keine konkurrierende zweite Fassung, die man priorisieren oder gegen die man abgleichen müsste. Wichtig ist, dass dieses Prinzip nicht durch eine zusätzliche Funktion erreicht wird, sondern durch das Datenmodell selbst. Eine Single Source of Truth lässt sich in einem verteilten Systemverbund bestenfalls nachbilden, indem man ein System zum führenden erklärt und die übrigen daraus versorgt – doch jede Replikation erzeugt erneut Kopien, deren Synchronität überwacht werden muss. Im integrierten Modell ist die Single Source of Truth keine Konvention, sondern eine physische Tatsache: Es gibt nur eine Tabelle, also nur eine Wahrheit.
Daraus folgt ein weiterer architektonischer Vorteil, der über die reine Fehlervermeidung hinausgeht: Auswertungen und Kennzahlen sind unmittelbar belastbar. Wenn Bestand, Einkaufswert und offene Aufträge aus derselben Datenbasis stammen, müssen sie nicht erst zueinander in Einklang gebracht werden – sie sind es bereits. In einer gekoppelten Landschaft hingegen ist eine systemübergreifende Auswertung immer nur so verlässlich wie der jüngste Abgleich, und jede Reporting-Abweichung wirft zuerst die Frage auf, ob ein Datenproblem oder ein Synchronisationsproblem vorliegt. Diese Belastbarkeit der Datenbasis ist einer der Gründe, warum eine integrierte ERP-Lösung gerade dann an Wert gewinnt, wenn Prozesse und Datenmengen wachsen.
Abgrenzung und Einordnung
Datenkonsistenz als Architekturmerkmal ist von der Verarbeitungslogik strikt zu trennen. Dass eine Lagerbuchung automatisch in die Buchhaltung durchschlägt, ist eine Frage der Prozessverzahnung; dass eine Verfügbarkeit in Echtzeit über Lager, Einkauf und Vertrieb hinweg berechnet wird, ist eine Frage der Auswertungslogik. Beide setzen die hier beschriebene gemeinsame Datenbasis voraus, behandeln aber etwas anderes – nämlich, was mit den Daten geschieht, nicht, ob sie überhaupt konsistent vorliegen. Der vorliegende Abschnitt beantwortet ausschließlich die Frage der Vorbedingung: Ob ein Artikel, ein Lieferant, ein Preis an einer einzigen Stelle existiert oder über Systemgrenzen hinweg abgeglichen werden muss.
Für die Praxis bedeutet das eine klare Empfehlung: Wer eine Warenwirtschaft einführt oder ablöst, sollte die Frage nach der Datenhaltung an den Anfang stellen, nicht an das Ende. Eine integrierte Warenwirtschaft erspart den gesamten Lebenszyklus aus Schnittstellenbau, Mapping-Pflege, Synchronisationsüberwachung und Konfliktbereinigung – ein Aufwand, der im gekoppelten Modell dauerhaft anfällt und mit der Zahl der Systeme überproportional wächst. Die scheinbar technische Entscheidung über das Datenmodell ist damit in Wahrheit eine betriebswirtschaftliche, denn sie bestimmt, wie viel Energie ein Unternehmen fortlaufend in das bloße Konsistenthalten seiner eigenen Daten investieren muss. Wer diese Weichenstellung früh und bewusst trifft, legt das Fundament, auf dem alle übrigen Stärken einer ERP-integrierten Warenwirtschaft erst tragfähig werden.
Bestandsbewegung trifft Wertefluss: Wie Lagerbuchungen automatisch in Finanzbuchhaltung und Kostenrechnung durchschlagen
Jede Lagerbewegung hat zwei Gesichter. Das eine ist physisch: Eine Palette verlässt den Lkw, ein Mitarbeiter scannt den Barcode, der Bestand einer Artikelnummer steigt um 200 Stück. Das andere ist wertmäßig: In demselben Augenblick erhöht sich das Vermögen des Unternehmens, ein Bestandskonto in der Bilanz wird bebucht, ein Anspruch oder eine Verbindlichkeit entsteht. In einer fragmentierten Systemlandschaft fallen diese beiden Gesichter auseinander - die Menge lebt im Lagerverwaltungssystem, der Wert wird Tage später manuell oder per Stapellauf in der Buchhaltung nachgezogen. In einer integrierten Warenwirtschaft sind sie hingegen ein einziger Vorgang, ausgelöst durch dieselbe Buchung. Genau diese Mengen-Wert-Kopplung ist der eigentliche Kern dessen, was ein ERP-System von einer reinen Lagersoftware unterscheidet.
Dieser Abschnitt vertieft, wie diese Kopplung technisch und buchhalterisch funktioniert: welche Konten eine Lagerbewegung anspricht, wie Bewertungsverfahren die Wertfindung steuern, wie zeitliche Differenzen zwischen Warenstrom und Belegstrom über Verrechnungskonten überbrückt werden und welche Wirkung Bestandsveränderungen am Ende in der Gewinn- und Verlustrechnung, der Bilanz und der Kostenrechnung entfalten.
Die doppelte Buchung hinter einer einzigen Lagerbewegung
Betrachten wir den Wareneingang im Detail. Der Lagermitarbeiter bucht den Zugang gegen eine Bestellung. Aus Sicht der Mengenführung passiert das Naheliegende: Der mengenmäßige Lagerbestand der betroffenen Artikel wird fortgeschrieben, die Bestellposition wird als geliefert markiert, gegebenenfalls ändert sich der Status der Verfügbarkeit. Gleichzeitig - und das ist der entscheidende Punkt - erzeugt das System eine wertmäßige Buchung, ohne dass jemand zusätzlich in der Finanzbuchhaltung tätig werden müsste.
Diese wertmäßige Buchung läuft im klassischen Fall über zwei Konten. Auf der Sollseite steht ein Bestandskonto (etwa "Roh-, Hilfs- und Betriebsstoffe" oder "Waren"), denn das Unternehmen besitzt nun mehr Vorräte. Auf der Habenseite steht zunächst nicht die Verbindlichkeit gegenüber dem Lieferanten, sondern ein Zwischenkonto: das Wareneingangs-Verrechnungskonto, oft "WE/RE-Konto" oder "GR/IR-Konto" (Goods Received / Invoice Received) genannt. Dieses Konto ist der buchhalterische Wartesaal zwischen physischer Lieferung und Rechnungseingang. Der Bestand ist schon da und damit bilanziert, aber die endgültige Verbindlichkeit gegenüber dem Lieferanten steht buchhalterisch noch aus, weil die Rechnung noch nicht eingetroffen ist.
Der entscheidende Mehrwert der Integration liegt darin, dass die Mengenbuchung den Wert nicht nur auslöst, sondern auch bestimmt. Das System kennt aus der Bestellung den Einkaufspreis, kennt aus dem Artikelstamm das hinterlegte Bewertungsverfahren und ermittelt daraus den Buchungswert vollautomatisch. Es gibt keine zweite Dateneingabe, keine Abtipp-Schleife, keinen separaten Beleg, der die Menge in einen Wert übersetzt. Wer verstehen will, warum diese Einheit von Vorgang und Verbuchung ohne Schnittstellenabgleich auskommt, findet die strukturelle Begründung im Abschnitt zur Datenintegrität weiter oben auf dieser Seite; hier interessiert uns ausschließlich, wie aus der Menge ein korrekter Wert wird.
1. Wareneingang erfassen
Menge: Zugang wird gegen die Bestellung gebucht, Artikelbestand steigt physisch. Auslöser für die parallele Wertspur.
2. Mengenmäßige Fortschreibung
Menge: Lagerbestand und Bestellstatus aktualisieren sich. Available-to-Promise und Dispositionskennzahlen rechnen sofort neu.
3. Wertmäßige Buchung
Wert: Bestandskonto (Soll) gegen WE/RE-Verrechnungskonto (Haben). Buchungswert = Menge mal bewertetem Einstandspreis nach hinterlegtem Verfahren.
4. Rechnungseingang
Wert: Lieferantenrechnung trifft ein und bucht das WE/RE-Konto auf (Soll) gegen Verbindlichkeiten und Vorsteuer (Haben).
5. Abgleich auf dem Verrechnungskonto
Wert: Stimmen Menge und Preis, gleicht sich das WE/RE-Konto auf null aus. Preis- oder Mengendifferenzen bleiben als Saldo sichtbar.
6. GuV- und Kostenrechnungswirkung
Wert: Beim Verbrauch oder Verkauf wird der Bestand erfolgswirksam aufgelöst, der Materialaufwand fließt in GuV und Deckungsbeitragsrechnung.
Bewertungsverfahren steuern die Kontierung
Die Frage "Welcher Wert wird gebucht?" ist alles andere als trivial, sobald derselbe Artikel zu unterschiedlichen Preisen eingekauft wird. Hier greifen die Bewertungsverfahren, die im Artikel- oder Bewertungsstamm hinterlegt sind und unmittelbar die Höhe der Buchung sowie die spätere Auflösung des Bestands bestimmen. Drei Verfahren dominieren in der Praxis.
Beim gleitenden Durchschnitt berechnet das System nach jedem Zugang einen neuen Durchschnittspreis aus altem Bestandswert plus Zugangswert geteilt durch die neue Gesamtmenge. Dieser eine Durchschnittswert ist dann für jede folgende Entnahme maßgeblich, bis der nächste Zugang ihn verschiebt. Der Charme liegt in der Einfachheit: Es gibt immer genau einen gültigen Bewertungspreis je Artikel, und Bestandsbuchungen lassen sich ohne Bezug auf konkrete Lieferungen durchführen. Der Preis dafür ist eine gewisse Glättung - Preisspitzen einzelner Einkäufe verschwimmen im Durchschnitt.
Bei FIFO (First In, First Out) unterstellt das System hingegen, dass die zuerst eingelagerte Ware auch zuerst verbraucht wird. Dafür muss es jede Zugangsschicht ("Layer") mit eigener Menge und eigenem Wert getrennt führen. Eine Entnahme greift dann zuerst die älteste Schicht ab und kontiert deren Einstandspreis als Aufwand. FIFO bildet bei steigenden Einkaufspreisen den Bestand näher am aktuellen Wiederbeschaffungswert ab, verlangt dem System aber eine schichtgenaue Mengen-Wert-Verwaltung ab - die Mengenspur und die Wertspur sind hier besonders eng verschränkt, weil jede Mengeneinheit ihren konkreten Wert mitführt.
Daneben existiert die Bewertung zum Standardpreis, bei der ein fest geplanter Verrechnungspreis je Artikel gilt. Jeder Zugang wird zu diesem Standard bewertet; weicht der tatsächliche Einkaufspreis ab, läuft die Differenz auf ein gesondertes Preisabweichungskonto. Dieses Verfahren ist in der Fertigung verbreitet, weil es Kalkulationen stabil hält und Abweichungen sichtbar isoliert. Die folgende Übersicht stellt die Verfahren gegenüber.
| Verfahren | Wertfindung beim Zugang | Wert bei Entnahme | Typische Eignung |
|---|---|---|---|
| Gleitender Durchschnitt | Neuer Mischpreis aus Alt- und Zugangswert | Aktueller Durchschnittspreis | Handel, homogene Artikel, einfacher Betrieb |
| FIFO (Schichten) | Eigene Wertschicht je Zugang | Wert der ältesten offenen Schicht | Steigende Preise, verderbliche Ware, IFRS-Nähe |
| Standardpreis | Fester Planpreis, Differenz auf Abweichungskonto | Standardpreis, konstant | Fertigung, stabile Kalkulation, Soll-Ist-Analyse |
Die Wahl des Verfahrens ist keine reine Buchhaltungsformalie, sondern wirkt direkt in die Kontierungslogik der Lagerbewegung hinein. Sie entscheidet, welcher Betrag beim Zugang auf das Bestandskonto fließt, welcher Aufwand bei der Entnahme entsteht und ob ein zusätzliches Abweichungskonto bespielt wird. In der Praxis ist die saubere Einrichtung dieser Verfahren ein klassisches Thema der ERP-Implementierung, weil eine spätere Umstellung Bestandsumbewertungen und entsprechende Buchungen nach sich zieht.
Abweichungen sauber führen: Preisdifferenzen und Wareneingang vor Rechnung
Die idealtypische Welt, in der Bestellpreis, Liefermenge und Rechnungsbetrag exakt übereinstimmen, ist selten. Drei Abweichungstypen muss eine integrierte Warenwirtschaft beherrschen, und sie löst sie alle über das WE/RE-Verrechnungskonto.
Der häufigste Fall ist der zeitliche Versatz: Wareneingang vor Rechnung. Die Ware ist physisch da und bilanziell als Bestand erfasst, aber die Rechnung trudelt erst Tage oder Wochen später ein. Ohne Verrechnungskonto entstünde hier eine Lücke - der Bestand wäre gebucht, die Gegenbuchung fehlte. Das WE/RE-Konto schließt diese Lücke: Es trägt nach dem Wareneingang einen Habensaldo, der die wirtschaftlich bereits bestehende, aber noch nicht fakturierte Verbindlichkeit abbildet. Erst der Rechnungseingang räumt diesen Saldo wieder ab. Der umgekehrte Fall - Rechnung vor Ware - funktioniert spiegelbildlich. Damit zeigt der Saldo des Verrechnungskontos jederzeit, wie viel Material geliefert, aber noch nicht abgerechnet ist (oder umgekehrt) - eine bilanziell relevante Information für die periodengerechte Abgrenzung.
Der zweite Fall ist die Preisdifferenz: Die Rechnung weist einen anderen Stückpreis aus als die Bestellung. Hier zeigt sich der Unterschied der Bewertungsverfahren erneut. Bei Standardpreisbewertung läuft die Differenz auf ein Preisdifferenzkonto und beeinflusst den Bestandswert nicht. Bei Durchschnitts- oder FIFO-Bewertung hingegen kann die Differenz - je nachdem, ob die Ware noch im Bestand liegt - den Bestandswert nachträglich korrigieren oder, falls bereits verbraucht, direkt erfolgswirksam in den Aufwand gebucht werden. Die Mengen-Wert-Kopplung bestimmt also auch hier, wohin eine reine Wertdifferenz fließt.
Der dritte Fall ist die Mengendifferenz: Es wurde mehr oder weniger geliefert als berechnet oder bestellt. Auch sie bleibt als Saldo auf dem Verrechnungskonto sichtbar, bis sie durch eine Korrekturbuchung, eine Nachlieferung oder eine Gutschrift aufgelöst wird. Genau diese Transparenz ist ein zentraler Grund, warum Unternehmen den Schritt von Insellösungen zu einer durchgängigen ERP-Lösung gehen: Das Verrechnungskonto wird zum permanenten Frühwarnsystem für unsaubere Beschaffungsvorgänge.
Eine Praxisregel sei betont: Ein dauerhaft hoher oder alter Saldo auf dem WE/RE-Verrechnungskonto ist fast immer ein Symptom, kein Zufall - fehlende Rechnungen, nie verbuchte Teillieferungen oder ungeklärte Preisdifferenzen. Die periodische Klärung dieses Kontos gehört deshalb zu den wichtigsten Routinen im Zusammenspiel von Einkauf, Wareneingang und Buchhaltung.
Von der Bestandsveränderung zur GuV- und Bilanzwirkung
Solange Material im Lager liegt, ist es Vermögen - es steht als Vorrat auf der Aktivseite der Bilanz und hat die Erfolgsrechnung noch nicht berührt. Der Wareneingang selbst ist deshalb erfolgsneutral: Er tauscht lediglich Vermögensformen (künftige Verbindlichkeit gegen Bestand). Erst wenn der Bestand das Lager verlässt - durch Verkauf, Verbrauch in der Produktion oder Abwertung -, wird er erfolgswirksam.
Beim Verkauf eines Handelsartikels oder beim Verbrauch eines Rohstoffs löst die Warenausgangsbuchung den hinterlegten Bestandswert auf und bucht ihn als Materialaufwand oder Wareneinsatz in die GuV. In diesem Moment wird der zuvor durch das Bewertungsverfahren festgelegte Wert relevant: Bei FIFO ist es der Wert der ältesten Schicht, beim gleitenden Durchschnitt der aktuelle Mischpreis. Die Mengenbuchung (Bestand sinkt) und die Wertbuchung (Aufwand entsteht) sind wieder ein einziger Vorgang. Dem steht auf der Ertragsseite der Umsatzerlös gegenüber, und die Differenz ist der Rohertrag.
Auch ohne Warenbewegung kann sich der Wert ändern: Die Niederstwertbewertung verlangt, Bestände bei gesunkenem Markt- oder Wiederbeschaffungswert abzuwerten. Eine solche Abwertung bucht eine reine Wertminderung in den Aufwand, während die Menge unverändert im Lager liegt - ein lehrreicher Fall, in dem die Wertspur sich ohne die Mengenspur bewegt. Bestandsdifferenzen aus der Inventur wirken spiegelbildlich: Eine festgestellte Fehlmenge reduziert sowohl den Mengenbestand als auch den Bilanzwert und schlägt als Aufwand in der GuV durch.
Der Brückenschlag in die Kostenrechnung und den Deckungsbeitrag
Die wertmäßige Abbildung der Lagerbewegung endet nicht in der Finanzbuchhaltung. Derselbe bewertete Materialwert, der als Wareneinsatz in die GuV fließt, ist die zentrale Eingangsgröße der Kostenrechnung. In der Deckungsbeitragsrechnung werden vom Umsatzerlös die variablen Kosten abgezogen - und der Wareneinsatz beziehungsweise die Materialeinzelkosten sind in vielen Geschäftsmodellen der größte variable Kostenblock. Weil die integrierte Warenwirtschaft diesen Wert direkt aus der bewerteten Lagerbewegung liefert, lässt sich der Deckungsbeitrag artikel-, auftrags- oder kundengenau ermitteln, ohne dass die Kostenrechnung ihre Materialwerte separat schätzen müsste.
Diese Durchgängigkeit erklärt, warum die Wahl des Bewertungsverfahrens auch eine Steuerungsfrage ist. Bewertet ein Unternehmen zum Standardpreis, fließt in den Deckungsbeitrag ein stabiler, planbarer Materialwert, und die Preisabweichungen werden als gesonderter Block analysiert - ideal für eine saubere Soll-Ist-Steuerung. Bewertet es zum gleitenden Durchschnitt, atmet der Deckungsbeitrag mit den tatsächlichen Einkaufspreisen, was die Marge realistischer, aber schwerer planbar macht. In beiden Fällen entsteht die Steuerungsinformation als Nebenprodukt derselben Lagerbuchung, die physisch ohnehin erfasst werden muss.
Hier liegt der eigentliche betriebswirtschaftliche Hebel der Mengen-Wert-Kopplung: Eine einzige, an der Rampe ausgelöste Buchung versorgt gleichzeitig die mengenmäßige Disposition, die wertmäßige Bilanzierung, die erfolgswirksame GuV und die entscheidungsorientierte Kostenrechnung. Gerade für den Mittelstand, der selten über eigene Controlling-Abteilungen für manuelle Wertüberleitungen verfügt, ist dieser automatische Durchgriff von der physischen Bewegung bis zum Deckungsbeitrag der entscheidende Unterschied zwischen einer Lagerverwaltung und einem echten betriebswirtschaftlichen Steuerungssystem.
Damit wird auch deutlich, warum die Bewertungs- und Kontierungslogik nicht erst am Ende eines Projekts betrachtet werden darf. Welche Bestandskonten geführt werden, welches Verfahren je Artikelgruppe gilt und wie das Verrechnungskonto überwacht wird, sind Festlegungen, die das gesamte Zahlenwerk prägen. Sie verbinden die scheinbar profane Lagerbewegung mit der Aussagekraft von Bilanz, Erfolgsrechnung und Margensteuerung - und machen aus einzelnen Buchungen ein konsistentes, sich selbst fortschreibendes Wertegerüst des Unternehmens.
Verfügbarkeit in Echtzeit: Available-to-Promise zwischen Lager, Einkauf, Produktion und Vertrieb
Die Frage, ob eine bestimmte Menge eines Artikels zu einem bestimmten Termin tatsächlich lieferbar ist, gehört zu den am häufigsten gestellten und gleichzeitig am schwersten zuverlässig zu beantwortenden Fragen im operativen Tagesgeschäft. Sie wird im Vertrieb gestellt, wenn ein Kunde am Telefon einen Liefertermin erwartet. Sie wird im Einkauf gestellt, wenn die Disposition entscheidet, ob nachbestellt werden muss. Und sie wird in der Produktion gestellt, wenn ein Fertigungsauftrag eingelastet wird und die benötigten Komponenten bereitstehen sollen. In schlecht integrierten Systemlandschaften beantwortet jeder Bereich diese Frage für sich selbst, mit eigenen Daten und eigenen Annahmen. Das integrierte ERP setzt an genau dieser Stelle an: Es definiert eine einzige, verbindliche Verfügbarkeitslogik, auf die alle Module gleichzeitig zugreifen. Dieser Abschnitt zeigt, wie diese Logik rechnerisch aufgebaut ist und wie die Reservierungs- und Allokationsmechanik dafür sorgt, dass dieselbe Zahl überall dieselbe Bedeutung hat.
Wichtig ist die Abgrenzung gleich zu Beginn: Es geht hier nicht um die bloße Sichtbarkeit von Beständen in Echtzeit, also nicht darum, dass alle Beteiligten denselben aktuellen Lagerstand sehen können. Es geht um die darüberliegende Rechenebene, die aus dem reinen Mengenstand erst eine belastbare Lieferzusage macht. Der Unterschied zwischen dem physisch im Regal liegenden Bestand und dem, was Sie einem Kunden tatsächlich versprechen dürfen, ist erheblich, und genau diesen Unterschied modelliert das Konzept des Available-to-Promise.
Vom physischen Bestand zur verbindlichen Zusage: Die Rechenlogik
Der disponible Bestand, im Englischen als Available-to-Promise (ATP) bezeichnet, ist keine gemessene Größe, sondern eine berechnete. Er entsteht aus mehreren Schichten, die ein integriertes Warenwirtschaftssystem übereinanderlegt. Die Grundformel lässt sich knapp fassen: disponibler Bestand gleich physischer Bestand minus Reservierungen plus erwartete Zugänge. Hinter jedem dieser drei Bestandteile steht ein eigener Datenhaushalt, der von einem jeweils anderen Modul gepflegt wird, und genau die Zusammenführung dieser Datenhaushalte ist die eigentliche Leistung der integrierten Verfügbarkeitsrechnung.
Der physische Bestand ist die unterste und scheinbar einfachste Schicht. Er beschreibt die Menge, die zum aktuellen Zeitpunkt buchhalterisch im Lager verbucht ist. Bereits hier zeigt sich allerdings, dass auch der physische Bestand kein einheitlicher Block ist: Er gliedert sich nach Lagerorten, nach Lagerplätzen, nach Chargen und Seriennummern sowie nach Bestandsstatus. Ware in Qualitätsprüfung, gesperrte Ware oder Konsignationsbestände zählen physisch zum Lager, stehen aber für eine Lieferzusage nicht oder nur eingeschränkt zur Verfügung. Die Verfügbarkeitslogik muss daher schon auf dieser untersten Ebene zwischen Brutto- und verfügbarem physischen Bestand unterscheiden.
Die zweite Schicht bilden die Reservierungen und Allokationen. Jede bestätigte Vertriebsorder, jeder eingelastete Fertigungsauftrag und jede interne Umlagerung kann Mengen aus dem physischen Bestand binden, lange bevor diese Mengen das Lager tatsächlich verlassen. Eine Reservierung ist eine verbindliche Vormerkung: Die Ware liegt noch im Regal, ist aber bereits einem konkreten Bedarf zugeordnet und darf kein zweites Mal verplant werden. Dieser Mechanismus verhindert die klassische Überverkaufssituation, in der zwei Aufträge unabhängig voneinander auf denselben letzten verfügbaren Bestand zugreifen. Subtrahiert man die Reservierungen vom physischen Bestand, erhält man den frei verfügbaren Bestand zum Stichtag.
Die dritte Schicht sind die erwarteten Zugänge. Hier verlässt die Rechnung den reinen Ist-Zustand und bezieht die Zukunft mit ein. Offene Bestellungen beim Lieferanten mit ihren bestätigten Anlieferterminen, laufende Fertigungsaufträge mit ihren geplanten Fertigstellungsterminen sowie erwartete Umlagerungen aus anderen Lagern erhöhen den künftig verfügbaren Bestand. Erst durch diese Schicht wird aus einer reinen Momentaufnahme eine zeitbezogene Aussage. Die entscheidende Größe ist daher nicht ein einzelner Wert, sondern ein terminierter Verfügbarkeitsverlauf: Zu jedem zukünftigen Zeitpunkt lässt sich angeben, wie viel Menge bis dahin zugesagt werden kann.
Aus diesen Schichten ergibt sich die oberste Ebene, das eigentliche Available-to-Promise. Es beantwortet nicht die Frage Wie viel liegt im Lager?, sondern die operativ relevante Frage Wie viel kann ich heute für welchen Termin verbindlich zusagen, ohne eine andere Zusage zu gefährden? Die folgende Schichtdarstellung fasst diesen Aufbau und die modulseitigen Zugriffe zusammen.
Eine Logik, drei Perspektiven: Wie die Module auf dieselbe Rechnung zugreifen
Der eigentliche Mehrwert entsteht nicht durch die Formel an sich, sondern dadurch, dass alle relevanten Module nicht mit eigenen Kopien, sondern mit demselben zugrunde liegenden Datenbestand arbeiten. In einer integrierten ERP-Lösung ist die Verfügbarkeitsrechnung kein Bericht, der nachts erzeugt und morgens verteilt wird, sondern ein lebendes Modell, das bei jeder relevanten Buchung sofort neu bewertet wird. Betrachten wir die drei Perspektiven einzeln.
Der Vertrieb beziehungsweise das Auftrags- und CRM-Modul greift im Moment der Auftragserfassung auf die oberste Schicht zu. Sobald eine Position erfasst wird, fragt das System: Steht die gewünschte Menge zum gewünschten Termin als ATP zur Verfügung? Lautet die Antwort ja, wird die Menge unmittelbar reserviert und damit aus dem disponiblen Bestand für alle anderen Vorgänge entfernt. Lautet die Antwort nein, kann das System einen späteren machbaren Termin vorschlagen, der sich aus den erwarteten Zugängen ergibt. Dieser Rückgriff auf zukünftige Zugänge ist der Übergang von ATP zu Capable-to-Promise (CTP): Während ATP nur mit bereits eingeplanten Zugängen rechnet, prüft CTP zusätzlich, ob ein zusätzlicher Beschaffungs- oder Fertigungsvorgang angestoßen werden könnte, um den Wunschtermin doch noch zu erreichen.
Der Einkauf und die Disposition betrachten dieselben Schichten unter umgekehrtem Vorzeichen. Für die Disposition ist nicht die Frage Was kann ich zusagen? relevant, sondern Wo entsteht eine Unterdeckung? Sinkt der disponible Bestand durch neue Reservierungen unter einen definierten Melde- oder Sicherheitsbestand, löst dies einen Beschaffungsvorschlag aus. Entscheidend ist, dass diese Disposition exakt dieselben Reservierungen sieht, die der Vertrieb soeben erzeugt hat. Es gibt keinen zeitlichen Versatz und keinen Abgleich zwischen getrennten Datenbeständen, weil es nur einen Datenbestand gibt. Die offene Bestellung, die der Einkauf daraufhin anlegt, fließt wiederum als erwarteter Zugang in die dritte Schicht ein und erhöht damit unmittelbar das ATP, das der Vertrieb für künftige Termine sieht.
Die Produktion und Produktionsplanung stehen an beiden Enden der Rechnung gleichzeitig. Einerseits erzeugt ein eingelasteter Fertigungsauftrag Reservierungen auf der Komponentenebene, weil die benötigten Materialien für diesen Auftrag gebunden werden, und reduziert damit deren disponiblen Bestand. Andererseits stellt derselbe Fertigungsauftrag für das Fertigerzeugnis einen erwarteten Zugang dar, der dessen ATP erhöht. Die Produktion ist damit zugleich Verbraucher von Verfügbarkeit auf der einen und Erzeuger von Verfügbarkeit auf der anderen Materialstufe. Wie die mehrstufige Auflösung von Stücklisten in Bedarfe übersetzt wird, ist Gegenstand eines eigenen Abschnitts dieser Seite; hier zählt allein, dass die so entstehenden Bedarfe und Zugänge in dieselbe Verfügbarkeitsrechnung einfließen wie die Vorgänge aus Vertrieb und Einkauf.
Der praktische Prüfstein für eine echte integrierte Verfügbarkeitslogik ist einfach: Wenn der Vertrieb eine Position bestätigt, muss die Disposition im selben Augenblick eine veränderte Unterdeckung sehen, und die Produktionsplanung muss die neue Materialbindung erkennen, ohne dass irgendein Abgleich, Import oder nächtlicher Lauf dazwischenliegt. Geschieht dies nicht synchron, arbeiten die Bereiche faktisch mit Kopien und nicht mit derselben Wahrheit.
Die Reservierungs- und Allokationsmechanik im Detail
Der Kern, der die gemeinsame Verfügbarkeitslogik tragfähig macht, ist die saubere Verwaltung von Reservierungen. Hier lohnt es sich, genauer hinzusehen, weil die Qualität eines Systems weniger an der Grundformel als an der Differenziertheit dieses Mechanismus hängt. Eine Reservierung kann unterschiedlich stark gebunden sein, und gute Systeme unterscheiden mehrere Stufen.
Auf der niedrigsten Stufe steht die weiche Reservierung: Eine Menge wird einem Bedarf rechnerisch zugeordnet, ist aber noch keinem konkreten physischen Bestand, keiner Charge und keinem Lagerplatz fest zugewiesen. Sie reduziert das ATP, lässt aber Spielraum, welche konkrete Ware später tatsächlich entnommen wird. Auf der höchsten Stufe steht die harte Allokation: Hier wird eine ganz bestimmte Menge aus einer ganz bestimmten Charge auf einem bestimmten Lagerplatz fest einem Auftrag zugeordnet, etwa weil der Kunde eine bestimmte Charge verlangt oder weil die Kommissionierung bereits begonnen hat. Diese Ware ist faktisch nicht mehr verfügbar und darf von keinem anderen Vorgang angetastet werden.
Zwischen diesen Polen liegt die Frage der Reservierungsreihenfolge und Priorität. Wenn mehrere Aufträge um denselben knappen Bestand konkurrieren, muss das System eine nachvollziehbare Regel anwenden. Verbreitet ist das Prinzip first come, first served nach Erfassungs- oder Bestätigungszeitpunkt. Anspruchsvollere Konfigurationen erlauben eine prioritätsgesteuerte Allokation, bei der etwa A-Kunden, vertraglich zugesicherte Mengen oder besonders margenstarke Aufträge bei der Zuteilung knapper Ware bevorzugt werden. In jedem Fall gilt: Die Regel muss zentral hinterlegt sein und für alle Module gleichermaßen gelten, sonst entstehen widersprüchliche Zusagen.
Ein häufig unterschätzter Aspekt ist die zeitliche Dimension der Verfügbarkeit. Eine sinnvolle ATP-Rechnung arbeitet nicht mit einem einzigen Stichtag, sondern mit einem fortlaufenden Zeitraster aus Verfügbarkeitsperioden. In jeder Periode werden die in diesem Zeitfenster fälligen Bedarfe den in diesem Fenster eintreffenden Zugängen gegenübergestellt. Daraus ergibt sich der periodenbezogene ATP-Wert, und durch Kumulation über die Perioden hinweg lässt sich der frühestmögliche Liefertermin für eine angefragte Menge exakt bestimmen. Genau diese terminierte Sichtweise erlaubt es dem Vertrieb, statt eines pauschalen lieferbar oder nicht lieferbar einen konkreten machbaren Termin zu nennen.
Die folgende Tabelle stellt gegenüber, welche Größe jeweils gemeint ist und welche Schicht der Verfügbarkeitsrechnung sie betrifft.
| Größe | Bedeutung | Betroffene Schicht |
|---|---|---|
| Physischer Bestand (brutto) | Gesamte verbuchte Menge im Lager, inklusive gesperrter und in Prüfung befindlicher Ware | Unterste Schicht |
| Frei verfügbarer Bestand | Physischer Bestand abzüglich aller Reservierungen und Allokationen zum Stichtag | Physisch minus Reservierungen |
| Reservierte Menge | Verbindlich vorgemerkte, aber noch nicht entnommene Ware, weich oder hart gebunden | Zweite Schicht |
| Erwarteter Zugang | Bestätigte künftige Mengen aus Bestellungen, Fertigung und Umlagerung | Dritte Schicht |
| Available-to-Promise (ATP) | Verbindlich zusagbare Menge je Termin aus bereits eingeplanten Zugängen | Ergebnisschicht |
| Capable-to-Promise (CTP) | Zusagbare Menge unter Berücksichtigung zusätzlich anstoßbarer Beschaffung oder Fertigung | Ergebnisschicht, erweitert |
Warum die gemeinsame Logik nur im integrierten System trägt
Die beschriebene Mechanik funktioniert nur dann verlässlich, wenn die drei Schichten aus einer einzigen Datenquelle gespeist werden. In dem Moment, in dem Vertrieb, Einkauf und Produktion mit getrennten Datenbeständen arbeiten, die über Schnittstellen synchronisiert werden, entsteht zwangsläufig ein Zeitfenster, in dem die Bestände auseinanderlaufen. Eine Reservierung, die im Vertriebssystem gesetzt wird, aber erst beim nächsten Abgleich im Dispositionssystem ankommt, ist für die Dauer dieses Fensters unsichtbar, und genau in diesem Fenster entstehen Doppelzusagen. Die integrierte ERP-Warenwirtschaft umgeht dieses Problem strukturell, weil es kein Fenster gibt: Jede Buchung wirkt sofort und für alle.
Daraus folgt eine Anforderung, die bei der Bewertung von Systemen oft zu wenig Gewicht bekommt. Die Verfügbarkeitsrechnung darf nicht als nachgelagerter Auswertungslauf konzipiert sein, der periodisch eine Bestandsliste erzeugt, sondern muss als unmittelbar reagierende Berechnung in den Buchungsfluss eingebettet sein. Wer in einer ERP-Auswahl die Eignung verschiedener Lösungen vergleicht, sollte deshalb gezielt prüfen, ob das System eine einheitliche, transaktional konsistente Verfügbarkeitsschicht bereitstellt oder ob es Verfügbarkeit lediglich pro Modul nachbildet und über Synchronisation zusammenführt. Der Unterschied ist im Demobetrieb leicht zu übersehen und im Echtbetrieb schwer zu korrigieren.
Ebenso bedeutsam ist die Frage, wie das System mit Stornierungen, Mengenänderungen und Terminverschiebungen umgeht. Eine robuste Verfügbarkeitslogik gibt reservierte Mengen sofort wieder frei, sobald ein Auftrag storniert oder reduziert wird, sodass die frei werdende Ware unverzüglich anderen Bedarfen zur Verfügung steht. Wird ein Anliefertermin einer Bestellung verschoben, muss sich der terminierte ATP-Verlauf aller davon abhängigen Artikel automatisch verschieben, einschließlich der daraus abgeleiteten Lieferterminzusagen. Diese Kaskade durchzurechnen ist rechnerisch anspruchsvoll, aber genau sie unterscheidet eine echte Verfügbarkeitslogik von einer statischen Bestandsanzeige.
Praktische Konsequenzen für das Tagesgeschäft
Für den Vertrieb bedeutet die gemeinsame Logik, dass eine am Telefon gegebene Zusage belastbar ist, weil sie auf demselben Datenstand beruht, den die Disposition und die Produktion in derselben Sekunde sehen. Es entfällt das Rückfragen in anderen Abteilungen, ob eine angezeigte Menge wirklich noch verfügbar ist. Für den Einkauf bedeutet sie, dass Beschaffungsvorschläge auf einer Bedarfsrechnung beruhen, die alle bereits gebundenen Mengen korrekt berücksichtigt, sodass weder unnötig bestellt noch ein Engpass übersehen wird. Für die Produktion bedeutet sie, dass die Materialverfügbarkeitsprüfung vor der Einlastung eines Auftrags auf denselben Bestand zugreift, der auch dem Vertrieb und dem Einkauf zugrunde liegt, sodass keine Aufträge eingeplant werden, deren Komponenten in Wahrheit bereits anderweitig verplant sind.
Gerade für wachsende Unternehmen im ERP-Mittelstand ist dieser Punkt von strategischer Bedeutung. Mit zunehmender Auftragsdichte und Artikelvielfalt steigt die Zahl der konkurrierenden Zugriffe auf denselben Bestand überproportional, und manuelle Abstimmung zwischen den Bereichen wird unmöglich. Eine einheitliche, terminierte Verfügbarkeitsrechnung, die Reservierungen sauber verwaltet und erwartete Zugänge korrekt einrechnet, ist deshalb kein Komfortmerkmal, sondern die Voraussetzung dafür, Lieferzusagen überhaupt zuverlässig geben zu können. Sie verwandelt den Bestand von einer reinen Mengenangabe in ein steuerbares Versprechen und macht damit die Verfügbarkeit selbst zu einer planbaren und verhandelbaren Größe im Zusammenspiel von Lager, Einkauf, Produktion und Vertrieb.
Von der Stückliste zum Lagerbestand: Warenwirtschaft als Bindeglied zwischen Beschaffung und Fertigung
In einem reinen Handelsbetrieb ist die Warenwirtschaft im Kern ein Durchlauferhitzer: Ein Artikel wird eingekauft, eingelagert, kommissioniert und verkauft - die Identität der Ware bleibt vom Wareneingang bis zum Versand unverändert. Sobald jedoch produziert wird, zerfällt diese saubere Eins-zu-eins-Beziehung. Aus mehreren eingekauften Komponenten entsteht ein neues, höherwertiges Erzeugnis, das es vorher im Lager gar nicht gab. Genau an dieser Stelle wird die Warenwirtschaft vom Verwalter eingekaufter Waren zum Bindeglied zwischen Beschaffung und Fertigung - sie muss nicht mehr nur Bestände fortschreiben, sondern Material gezielt für einen Fertigungsauftrag reservieren, zum richtigen Zeitpunkt entnehmen, in der Produktion als Ware-in-Arbeit binden und schließlich das fertige Erzeugnis als neuen Bestand wieder einlagern.
Dieser Abschnitt behandelt ausschließlich diesen Produktions-Lager-Kreislauf: das Zusammenspiel von Stückliste, Materialbedarfsplanung, Reservierung, Materialentnahme und Rückmeldung. Die Grundprozesse von Einkauf und Verkauf, die Echtzeit-Verfügbarkeit und die wertmäßige Verbuchung von Beständen sind Gegenstand anderer Abschnitte dieser Seite. Hier steht die Frage im Mittelpunkt, wie ein Warenwirtschaftssystem die Brücke zwischen dem schlagen muss, was beschafft wird, und dem, was gefertigt wird - und warum eine reine Handelswarenwirtschaft genau diese Integrationsstrecke typischerweise nicht abbildet.
Stückliste und Fertigungsauftrag: Der Bauplan trifft den Bestand
Das verbindende Stammdatenobjekt zwischen Lager und Produktion ist die Stückliste (englisch Bill of Materials, kurz BOM). Sie beschreibt, aus welchen Komponenten und in welchen Mengen ein Erzeugnis zusammengesetzt ist. Eine Stückliste für einen Pumpenmotor listet etwa ein Gehäuse, einen Rotor, zwei Lager, eine bestimmte Länge Kabel und eine Handvoll Schrauben - jede Position mit einer Artikelnummer, die zugleich eine Position im Lagerbestand ist. Die Stückliste ist damit der Übersetzer zwischen der Welt der Beschaffung (Komponenten, die eingekauft und eingelagert werden) und der Welt der Fertigung (Erzeugnisse, die montiert werden).
Entscheidend ist, dass eine Stückliste in einem produzierenden Umfeld selten flach ist. Sie ist mehrstufig: Der Pumpenmotor geht seinerseits als Komponente in eine komplette Pumpe ein, die Pumpe wiederum in eine Pumpstation. Jede Ebene definiert ein eigenständiges Material mit eigenem Lagerbestand. Komponenten, die das Unternehmen nicht einkauft, sondern selbst fertigt und zwischenlagert, heißen Halbfabrikate oder Baugruppen. Sie sind das eigentliche Unterscheidungsmerkmal gegenüber der Handelswarenwirtschaft: Ein Halbfabrikat hat einen Lagerbestand, taucht aber weder im Einkauf noch im Verkauf direkt auf - es entsteht ausschließlich aus einem internen Fertigungsschritt und wird ausschließlich von einem weiteren internen Fertigungsschritt verbraucht.
Der Fertigungsauftrag ist das Bewegungsobjekt, das diese Stammdaten in Bestandsbewegungen übersetzt. Er sagt: Fertige Menge X von Erzeugnis Y bis Termin Z. Aus der Stückliste leitet das System ab, welche Komponenten in welcher Menge dafür benötigt werden, und aus dem Arbeitsplan, welche Arbeitsschritte und Kapazitäten erforderlich sind. Der Fertigungsauftrag ist damit gleichzeitig ein Materialverbraucher (er entnimmt Komponenten aus dem Lager) und ein Materialproduzent (er liefert ein Fertigerzeugnis oder Halbfabrikat ins Lager zurück). Eine reine Handelswarenwirtschaft kennt dieses Objekt nicht; sie kennt nur Zugänge aus Bestellungen und Abgänge aus Aufträgen, aber keine Transformation von Bestand in anderen Bestand.
Materialbedarfsplanung: Wie aus Primärbedarf Sekundärbedarf wird
Das Verfahren, das den Bauplan der Stückliste mit dem realen Bestand verrechnet, ist die Materialbedarfsplanung (englisch Material Requirements Planning, kurz MRP). Sie beantwortet die Kernfrage des produzierenden Betriebs: Was muss ich beschaffen oder fertigen, damit ich rechtzeitig liefern kann - und was habe ich davon bereits? MRP arbeitet dabei mit einer klaren Begriffshierarchie, die den Unterschied zwischen Beschaffung und Fertigung sauber abbildet.
Den Ausgangspunkt bildet der Primärbedarf: der Bedarf an verkaufsfähigen Enderzeugnissen, der entweder aus konkreten Vertriebsaufträgen oder aus einer Absatzplanung stammt. Der Primärbedarf ist marktgetrieben - er sagt, was das Unternehmen nach außen liefern will. Aus ihm leitet die Stücklistenauflösung den Sekundärbedarf ab: den Bedarf an Komponenten, Baugruppen und Rohstoffen, die zur Herstellung der Enderzeugnisse erforderlich sind. Wird ein Sekundärbedarf auf eine selbstgefertigte Baugruppe gebucht, wird diese Baugruppe ihrerseits aufgelöst und erzeugt Sekundärbedarfe auf der nächsttieferen Ebene - so arbeitet sich MRP Stufe für Stufe durch die mehrstufige Stückliste nach unten.
Bevor MRP einen Beschaffungs- oder Fertigungsvorschlag erzeugt, prüft es die Nettobedarfsrechnung: Vom Bruttobedarf werden der verfügbare Lagerbestand, bereits offene Bestellungen und laufende Fertigungsaufträge abgezogen. Nur die ungedeckte Restmenge wird zum Nettobedarf, für den überhaupt etwas veranlasst werden muss. Genau hier verbindet sich die Bedarfsrechnung mit dem Lagerbestand: MRP rechnet nicht im luftleeren Raum, sondern gegen den real verfügbaren Bestand und gegen das, was bereits unterwegs ist. Wie die zugrunde liegende Verfügbarkeit zwischen Lager, Einkauf und Produktion in Echtzeit ermittelt wird, ist Thema eines eigenen Abschnitts dieser Seite; hier interessiert ausschließlich, dass der Nettobedarf der Auslöser für die nachgelagerten Bestandsbewegungen ist.
Aus dem Nettobedarf entsteht je nach Beschaffungsart der Komponente eine von zwei Konsequenzen. Bei einer Fremdbezugskomponente erzeugt MRP einen Bestellvorschlag Richtung Einkauf. Bei einer Eigenfertigungskomponente erzeugt es einen Fertigungsauftragsvorschlag Richtung Produktion - und dieser Auftrag erzeugt wiederum Sekundärbedarfe auf seine eigenen Komponenten. Diese Verzweigung zwischen Beschaffung und Fertigung an jeder einzelnen Stücklistenposition ist der Kern dessen, was die Warenwirtschaft hier leisten muss und was ein Standalone-System nicht abbildet.
Reservierung: Wie verfügbarer Bestand einem Auftrag zugeordnet wird
Sobald ein Fertigungsauftrag existiert oder geplant ist, stellt sich eine Frage, die im Handel keine Rolle spielt: Welcher Bestand gehört eigentlich noch wem? In einem produzierenden Betrieb konkurrieren mehrere Fertigungsaufträge um dieselben Komponenten. Würde das System nur den physischen Lagerbestand führen, könnte derselbe Posten Schrauben rechnerisch mehreren Aufträgen gleichzeitig zugesagt werden - mit dem Ergebnis, dass beim zweiten Auftrag das Material an der Maschine fehlt.
Die Reservierung löst dieses Problem, indem sie verfügbaren Bestand fest an einen Bedarf bindet, ohne ihn physisch zu bewegen. Reservierter Bestand bleibt mengenmäßig im Lager, ist aber dispositiv nicht mehr frei verfügbar. Damit entsteht die wichtige Unterscheidung zwischen physischem Bestand (was tatsächlich im Regal liegt) und frei verfügbarem Bestand (physischer Bestand abzüglich aller Reservierungen). MRP rechnet konsequent gegen den frei verfügbaren Bestand, sodass bereits reservierte Mengen keinem weiteren Auftrag mehr zugesagt werden können.
Buchhalterisch ist die Reservierung eine reine Dispositions- oder Vormerkbuchung: Sie verändert weder den Lagerort noch den physischen Bestand, sondern setzt lediglich ein Kennzeichen, das die Verfügbarkeit reduziert. Genau diese Fähigkeit, Bestand zu binden, ohne ihn zu bewegen, ist eine der Integrationsleistungen, die eine produktionsfähige Warenwirtschaft von einer reinen Lagerverwaltung unterscheidet. Sie sorgt dafür, dass die Planung verlässlich ist, bevor das erste Teil tatsächlich aus dem Regal genommen wird. Welche ERP-Lösung ein Unternehmen wählt, hängt nicht zuletzt davon ab, wie feingranular und mehrstufig sie diese Reservierungslogik abbildet.
Merksatz: Im Handel kennt die Warenwirtschaft im Wesentlichen zwei Bestandszustände - vorhanden oder nicht. In der Fertigung muss sie mindestens vier unterscheiden: frei verfügbar, reserviert, in Arbeit (WIP) und fertiggestellt. Jeder Übergang zwischen diesen Zuständen ist eine eigene, nachvollziehbare Bestandsbuchung - und genau diese Zustandsübergänge bildet ein Standalone-Warenwirtschaftssystem typischerweise nicht ab.
Der Weg vom Bedarf zur Bestandswirkung
Wie greifen diese Bausteine nun ineinander? Die folgende Schrittfolge zeigt den vollständigen Kreislauf vom marktseitigen Primärbedarf bis zur Rückmeldung des fertigen Erzeugnisses - und annotiert jeden Schritt mit der Bestandsbuchung, die er auslöst. Wichtig ist dabei: Manche Schritte sind reine Dispositionsbuchungen, die nichts physisch bewegen, andere sind echte Mengenbewegungen im Lager. Erst das Zusammenspiel beider Arten ergibt den geschlossenen Produktions-Lager-Kreislauf.
- 1. Primärbedarf erfassen: Ein Vertriebsauftrag oder ein Planungssatz meldet den Bedarf an einem verkaufsfähigen Enderzeugnis an. Bestandswirkung: noch keine Buchung im Lager - der Bedarf ist angemeldet, aber nicht disponiert.
- 2. Stückliste auflösen: Das System löst die mehrstufige Stückliste des Erzeugnisses auf und ermittelt, welche Komponenten und Baugruppen in welcher Menge benötigt werden. Bestandswirkung: Erzeugung von Bruttobedarfen je Komponente, noch keine Mengenbuchung.
- 3. MRP ermittelt Sekundärbedarf: Die Nettobedarfsrechnung zieht vom Bruttobedarf den frei verfügbaren Bestand sowie offene Bestellungen und Fertigungsaufträge ab. Bestandswirkung: Ausweis des ungedeckten Nettobedarfs je Komponente.
- 4. Bestände reservieren: Für die gedeckten Mengen bindet das System verfügbaren Lagerbestand fest an den Bedarf. Bestandswirkung: Dispositionsbuchung - frei verfügbarer Bestand sinkt, physischer Bestand bleibt unverändert.
- 5. Bestellvorschlag oder Fertigungsauftrag erzeugen: Für die ungedeckte Nettomenge entsteht je nach Beschaffungsart ein Bestellvorschlag (Fremdbezug) oder ein Fertigungsauftrag (Eigenfertigung); letzterer löst erneut Sekundärbedarfe aus. Bestandswirkung: Erhöhung des disponierten Zugangs, der den künftigen Bestand vormerkt.
- 6. Material entnehmen: Mit dem Start der Fertigung werden die reservierten Komponenten physisch aus dem Lager an den Auftrag abgebucht. Bestandswirkung: Abgang vom Komponentenbestand, Zugang auf den Bestand Ware-in-Arbeit (WIP) des Auftrags.
- 7. Fertigerzeugnis zurückmelden: Nach Abschluss der Arbeitsschritte meldet die Produktion die fertige Menge zurück ins Lager. Bestandswirkung: Abgang vom WIP-Bestand, Zugang des Fertigerzeugnisses (oder Halbfabrikats) in den frei verfügbaren Lagerbestand.
Bemerkenswert an dieser Kette ist, dass sie einen Bestand nicht einfach erhöht oder verringert, sondern ihn transformiert: Aus mehreren Komponentenbeständen, die im Lager verschwinden, entsteht ein neuer, höherwertiger Erzeugnisbestand, der im Lager auftaucht. Genau diese Bestandstransformation über einen Zwischenzustand hinweg ist die Integrationsleistung, die eine produktionsfähige Warenwirtschaft erbringt und die eine reine Handelswarenwirtschaft gar nicht erst vorsieht.
Ware-in-Arbeit: Der unsichtbare Bestand zwischen Entnahme und Rückmeldung
Zwischen Schritt sechs und Schritt sieben der obigen Kette liegt ein Bestandszustand, den der Handel nicht kennt: die Ware-in-Arbeit, im Englischen Work in Process oder kurz WIP. In dem Moment, in dem Komponenten aus dem Lager an einen Fertigungsauftrag entnommen werden, verschwinden sie aus dem Lagerbestand - aber sie sind noch kein Fertigerzeugnis. Sie befinden sich in einem Schwebezustand: physisch an der Maschine oder in der Montagelinie, mengenmäßig dem Fertigungsauftrag zugeordnet, wertmäßig als angefangene Leistung gebunden.
Eine Warenwirtschaft, die Produktion ernst nimmt, führt diesen WIP-Bestand explizit. Er beantwortet die Frage, wie viel Material aktuell in laufenden Aufträgen gebunden ist - eine Größe, die für die Liquiditäts- und Kapazitätsplanung erheblich ist, weil in der angefangenen Fertigung Kapital steckt, das weder als verkaufsfähiges Erzeugnis noch als frei verfügbarer Rohstoff zur Verfügung steht. Im Handel gibt es diesen Zustand schlicht nicht: Eine Ware ist entweder im Lager oder verkauft, niemals in einem produktiven Zwischenzustand. Die Fähigkeit, WIP sauber zu führen, ist deshalb ein verlässlicher Lackmustest dafür, ob ein System wirklich für produzierende Betriebe taugt oder nur eine aufgebohrte Handelswarenwirtschaft ist - ein Kriterium, das in jeder seriosen ERP-Auswahl für ein Fertigungsunternehmen ganz oben stehen sollte.
Der WIP-Bestand schließt auch eine wichtige Lücke in der Nachvollziehbarkeit. Geht in der Fertigung etwas verloren, wird Ausschuss produziert oder bleibt ein Auftrag liegen, dann zeigt der WIP-Saldo dieses Material an - es ist aus dem Lager entnommen, aber nicht als Erzeugnis zurückgemeldet worden. Ein dauerhaft hoher oder alter WIP-Saldo auf einem Auftrag ist damit ein ebenso aussagekräftiges Frühwarnsignal wie ein offener Posten - er deutet auf nicht abgeschlossene Aufträge, fehlende Rückmeldungen oder unverbuchten Ausschuss hin.
Rückmeldung von Ist-Verbräuchen: Wo Plan und Realität sich treffen
Der vielleicht unterschätzteste Teil des Produktions-Lager-Kreislaufs ist die Rückmeldung. Die Stückliste ist eine Soll-Vorgabe: Sie sagt, wie viel Material ein Erzeugnis theoretisch verbrauchen sollte. Die Realität weicht davon ab - durch Ausschuss, Verschnitt, Schwund, Nacharbeit oder schlicht durch Mehr- oder Minderverbrauch. Die Rückmeldung ist der Mechanismus, mit dem die Produktion dem System mitteilt, was tatsächlich verbraucht und tatsächlich gefertigt wurde.
Hier sind zwei Verfahren zu unterscheiden. Bei der Hinterlegungsbuchung (englisch Backflush) bucht das System den Materialverbrauch automatisch anhand der Stückliste in dem Moment, in dem die Fertigmenge zurückgemeldet wird - es unterstellt also, dass exakt die geplante Materialmenge verbraucht wurde. Das ist effizient und reduziert den Erfassungsaufwand, setzt aber voraus, dass Soll und Ist eng beieinanderliegen. Bei der expliziten Verbrauchsrückmeldung erfasst die Produktion dagegen die tatsächlich entnommenen Mengen einzeln, sodass jede Abweichung vom Stücklisten-Soll sichtbar wird.
Die Differenz zwischen geplantem und tatsächlichem Verbrauch ist betriebswirtschaftlich hochrelevant, denn sie korrigiert den Lagerbestand auf den realen Stand und macht Materialeffizienz messbar. Wird mehr verbraucht als geplant, sinkt der Komponentenbestand stärker als kalkuliert - was ohne Rückmeldung zu einer schleichenden Differenz zwischen Buchbestand und physischem Bestand führen würde, bis die nächste Inventur sie schmerzhaft aufdeckt. Die folgende Tabelle stellt die beiden Verfahren gegenüber.
| Aspekt | Hinterlegungsbuchung (Backflush) | Explizite Verbrauchsrückmeldung |
|---|---|---|
| Auslöser der Verbrauchsbuchung | Automatisch mit der Fertigmeldung | Manuelle oder gescannte Erfassung je Entnahme |
| Verbrauchsmenge | Stückliste-Soll pro Fertigmenge | Tatsächlich entnommene Ist-Menge |
| Erfassungsaufwand | Gering | Höher |
| Sichtbarkeit von Abweichungen | Erst bei Inventur oder Korrektur | Unmittelbar je Auftrag |
| Geeignet für | Stabile Prozesse, geringe Streuung | Variantenreiche oder schwankende Fertigung |
In der Praxis kombinieren viele Betriebe beide Ansätze: Günstige Massenkleinteile wie Schrauben werden per Backflush gebucht, hochwertige oder kritische Komponenten dagegen explizit zurückgemeldet. Die Rückmeldung schließt den Kreislauf, indem sie nicht nur den Komponentenbestand fortschreibt, sondern auch den Zugang des Fertigerzeugnisses oder Halbfabrikats auslöst - jenes neuen Bestands, der zuvor in keiner Beschaffung auftauchte und allein aus der internen Wertschöpfung entstanden ist.
Warum der Kreislauf eine Integrationsstrecke ist - und kein Standalone-Feature
Fasst man die Schritte zusammen, wird deutlich, warum dieser Produktions-Lager-Kreislauf die Trennlinie zwischen einer Handelswarenwirtschaft und einem fertigungsfähigen System markiert. Eine reine Handelswarenwirtschaft führt Zugänge und Abgänge, kennt aber keine Stücklistenauflösung, keine Sekundärbedarfsrechnung, keinen Zustand der Ware-in-Arbeit und keine Verbrauchsrückmeldung gegen ein Stücklisten-Soll. Sie kann nicht abbilden, dass ein Bestand sich in einen anderen verwandelt. Genau diese Transformation - Komponenten hinein, Erzeugnis heraus, dazwischen ein gebundener Zwischenbestand - ist keine isolierte Funktion, sondern eine Integrationsstrecke, die Stammdaten (Stückliste, Arbeitsplan), Disposition (MRP, Reservierung) und Bewegungsdaten (Entnahme, Rückmeldung) durchgängig verbindet.
Wer vor der Entscheidung steht, ob ein vorhandenes Handelssystem ausreicht oder ob es ein produktionsfähiges System braucht, sollte deshalb nicht auf einzelne Häkchen in einer Funktionsliste schauen, sondern prüfen, ob dieser Kreislauf als geschlossene Strecke funktioniert: Löst ein Primärbedarf saubere, mehrstufige Sekundärbedarfe aus? Werden Bestände reserviert, bevor sie entnommen werden? Existiert ein expliziter WIP-Bestand? Schreibt die Rückmeldung sowohl Komponenten als auch Erzeugnis fort? Diese Fragen gehören in jedes Lastenheft eines produzierenden Betriebs - und ihre Beantwortung trennt die Anbieter, deren Warenwirtschaft wirklich an die Fertigung andockt, von jenen, die lediglich ein Handelsmodul mit einem aufgesetzten Stücklistenfeld anbieten. Die Integrationsstrecke vom Primärbedarf bis zur Rückmeldung ist damit nicht nur eine technische Kette, sondern das entscheidende betriebswirtschaftliche Kriterium dafür, ob die Warenwirtschaft ihre Rolle als Bindeglied zwischen Beschaffung und Fertigung tatsächlich ausfüllt.
Skalierungsgrenzen der gekoppelten Welt: Wann Schnittstellen-Wildwuchs zur Bremse wird
Eine Standalone-Warenwirtschaft, die über Schnittstellen an Buchhaltung, Versand, Webshop, CRM und Produktionsplanung angebunden ist, funktioniert in der frühen Wachstumsphase eines Unternehmens oft erstaunlich gut. Jedes System tut, wofür es gekauft wurde, und die Konnektoren transportieren die wenigen wirklich relevanten Datensätze von einem Programm zum nächsten. Genau diese anfängliche Funktionsfähigkeit ist jedoch trügerisch, denn sie verdeckt eine strukturelle Eigenschaft gekoppelter Landschaften: Ihr Aufwand wächst nicht linear mit dem Geschäft, sondern überproportional. Dieser Abschnitt beschreibt nicht, wie eine Migration abläuft, und auch nicht, warum eine integrierte Datenbasis Abgleiche grundsätzlich überflüssig macht; beides ist Gegenstand anderer Abschnitte dieser Seite. Hier geht es ausschließlich um die Skalierungslogik selbst: an welchen konkreten Wachstumspunkten eine gekoppelte Welt an ihre Grenzen stößt, woran man das frühzeitig erkennt und warum diese Grenzen architektonischer und nicht nur betrieblicher Natur sind.
Die zentrale These lautet: Schnittstellen sind kein neutrales Verbindungsstück, sondern eine eigene Belastungsquelle, die mit jedem zusätzlichen System, jedem zusätzlichen Mandanten und jedem zusätzlichen Datenvolumen mitwächst. Solange die Landschaft klein ist, bleibt diese Belastung unsichtbar. Ab einer bestimmten Schwelle kippt das Verhältnis, und der Aufwand für den Erhalt der Kopplung beginnt, den Nutzen der einzelnen Spezialsysteme aufzuzehren. Dieses Kippen vollzieht sich selten als einzelnes Ereignis, sondern als schleichende Verschlechterung, die erst spät als das erkannt wird, was sie ist: eine Skalierungsgrenze der Architektur.
Das n-Quadrat-Problem: Warum Schnittstellen schneller wachsen als Systeme
Der mathematische Kern des Problems ist schlicht und unerbittlich. Wenn jedes System mit jedem anderen direkt gekoppelt werden soll, wächst die Zahl der möglichen Punkt-zu-Punkt-Verbindungen nach der Formel n mal (n minus 1) geteilt durch zwei, wobei n die Anzahl der Systeme bezeichnet. Diese Beziehung ist nicht linear, sondern quadratisch. Drei Systeme erfordern höchstens drei Verbindungen, was sich noch überblicken lässt. Fünf Systeme erfordern bereits zehn, sieben Systeme einundzwanzig und zehn Systeme bereits fünfundvierzig mögliche Verbindungen. Der entscheidende Punkt ist die Steigung: Jedes neue System, das hinzukommt, erzeugt nicht eine, sondern potenziell so viele neue Schnittstellen, wie es bereits Systeme gibt.
In der Praxis wird selten jedes System mit jedem verbunden, aber die Tendenz bleibt bestehen, und sie wird durch eine zweite Dimension verschärft. Jede Verbindung ist nämlich nicht ein einzelnes statisches Objekt, sondern ein eigenes kleines Projekt mit eigener Datenfeld-Zuordnung, eigener Fehlerbehandlung, eigenem Protokoll und eigenem Lebenszyklus. Eine Schnittstelle muss spezifiziert, entwickelt, getestet, dokumentiert, überwacht und bei jeder Änderung an einem der beiden Endpunkte angepasst werden. Die quadratisch wachsende Zahl an Verbindungen multipliziert sich also mit einem konstanten, aber keineswegs kleinen Pflegeaufwand je Verbindung. Das Ergebnis ist eine Aufwandskurve, die in der Anfangsphase flach und gutmütig verläuft und ab einer mittleren Systemzahl steil ansteigt.
Diesem Wildwuchs steht das integrierte Modell als architektonischer Gegenentwurf gegenüber. In einer durchgängigen ERP-Lösung teilen sich alle Funktionsbereiche eine einzige gemeinsame Datenbasis, sodass die Zahl der inneren Abstimmungsverbindungen unabhängig von der Zahl der Module konstant bleibt. Ob drei oder dreizehn Funktionsbereiche auf denselben Datenbestand zugreifen, ändert nichts an der Grundarchitektur: Es gibt weiterhin genau eine Wahrheit, auf die alle lesend und schreibend zugreifen. Externe Anbindungen bleiben natürlich auch hier nötig, aber sie verlaufen über einen definierten Rand und nicht durch das Innere der Landschaft. Die folgende Darstellung macht diesen Unterschied in Zahlen sichtbar.
Die Aussagekraft dieser Zahlen liegt nicht im einzelnen Wert, sondern in der Form der Kurve. Während die gekoppelte Welt einem quadratischen Anstieg folgt, bleibt die integrierte Welt bei der Eins. Genau dieser Unterschied zwischen einer wachsenden und einer konstanten Größe ist der eigentliche Grund, warum gekoppelte Landschaften irgendwann an eine Wand laufen, integrierte hingegen nicht. Die Wand ist nicht eine Frage der Technik einer einzelnen Schnittstelle, sondern eine Frage der schieren Anzahl.
Wartungs- und Versionsabhängigkeiten: Die unsichtbare Kopplungsschuld
Die reine Zahl der Verbindungen erfasst das Problem nur zur Hälfte. Die zweite, oft schwerwiegendere Dimension ist die gegenseitige Abhängigkeit der gekoppelten Systeme in ihrer zeitlichen Entwicklung. Jedes der angebundenen Programme wird von seinem Hersteller weiterentwickelt, erhält Updates, neue Funktionen und gelegentlich grundlegend veränderte Datenmodelle. Sobald eines dieser Systeme seine Schnittstellenstruktur ändert, ein Feldformat anpasst oder ein Datenfeld umbenennt, kann jede Verbindung brechen, die auf das alte Verhalten gebaut war. Was zuvor zuverlässig lief, liefert plötzlich leere Felder, falsch zugeordnete Werte oder gar keine Daten mehr.
Daraus entsteht eine Form von technischer Schuld, die man als Versions-Patt bezeichnen kann. Das Unternehmen könnte ein wichtiges Update für den Webshop oder die Buchhaltung einspielen, um Sicherheitslücken zu schließen oder neue Funktionen zu nutzen, traut sich aber nicht, weil unklar ist, welche der angebundenen Schnittstellen das Update überleben würden. So entsteht der paradoxe Zustand, dass die Beweglichkeit des Gesamtsystems mit jeder zusätzlichen Kopplung abnimmt. Je mehr Systeme verbunden sind, desto größer ist die Wahrscheinlichkeit, dass irgendwo eine Änderung ansteht, und desto kleiner ist gleichzeitig der Spielraum, sie gefahrlos durchzuführen. Die Landschaft erstarrt in ihrer eigenen Vernetzung.
Verschärfend kommt hinzu, dass die Verantwortung für die Schnittstellen meist diffus verteilt ist. Der Hersteller der Warenwirtschaft verantwortet sein Produkt, der Anbieter des Webshops das seine, und der Konnektor dazwischen stammt womöglich von einem dritten Dienstleister oder ist intern gebaut worden. Bricht eine Verbindung, beginnt die Suche nach dem Verursacher, und nicht selten verweist jede Partei auf die andere. Diese unklare Zuständigkeit ist kein Randproblem, sondern eine direkte Folge der gekoppelten Architektur: Wo Verantwortung über viele Endpunkte verteilt ist, gibt es keinen natürlichen Ort, an dem ein Problem gelöst werden muss. In Auswahlprozessen wird dieser Punkt regelmäßig unterschätzt; eine strukturierte ERP-Auswahl sollte die Gesamtkosten einer Landschaft daher immer einschließlich des fortlaufenden Schnittstellen-Lebenszyklus betrachten und nicht nur die Lizenz- und Einführungskosten der Einzelsysteme.
Batch statt Echtzeit: Die zeitliche Lücke zwischen den Systemen
Eine dritte Skalierungsgrenze betrifft nicht die Zahl, sondern die Taktung der Datenflüsse. Punkt-zu-Punkt-Schnittstellen werden aus Aufwands- und Lastgründen häufig nicht in Echtzeit, sondern stapelweise betrieben. Bestände, Aufträge, Belege und Stammdaten werden in festen Intervallen abgeglichen, klassischerweise in einem nächtlichen Lauf, manchmal stündlich, selten minütlich. Dieser Batch-Betrieb ist in kleinen Landschaften eine pragmatische und völlig vertretbare Entscheidung. Mit wachsendem Geschäft wird er jedoch zur strukturellen Schwachstelle, weil zwischen zwei Läufen jedes System eine andere Sicht auf die Wirklichkeit hat.
Der praktische Effekt ist die Bestandsdifferenz im Zeitfenster. Verkauft der Webshop um zehn Uhr morgens die letzten Einheiten eines Artikels, die Warenwirtschaft erfährt davon aber erst beim nächtlichen Abgleich, dann kann derselbe Bestand zwischenzeitlich ein zweites Mal verkauft oder einem Auftrag zugesagt werden. Es entsteht eine Überverkaufssituation, die nicht aus einem Fehler, sondern aus der zeitlichen Lücke der Kopplung resultiert. Je höher die Transaktionsfrequenz, desto häufiger fällt eine Buchung in genau dieses Fenster, und desto wahrscheinlicher werden Differenzen. Was bei wenigen Vorgängen pro Tag eine seltene Ausnahme ist, wird bei hoher Frequenz zur täglichen Störung. Die Skalierungsgrenze liegt hier also nicht bei der Datenmenge an sich, sondern beim Verhältnis von Transaktionsfrequenz zur Abgleichfrequenz.
Die naheliegende Reaktion, die Läufe einfach häufiger anzustoßen, hilft nur begrenzt. Jeder Lauf erzeugt Last auf beiden Seiten und braucht Zeit; mit wachsendem Datenvolumen dauern die Läufe länger, sodass das Fenster, in dem man sie verkürzen könnte, sich gleichzeitig schließt. Im Extremfall ist ein nächtlicher Vollabgleich morgens noch nicht abgeschlossen, wenn der Betrieb wieder anläuft. Echtzeitnahe Konnektoren existieren zwar, sie verlagern das Problem aber lediglich auf eine technisch anspruchsvollere Ebene und potenzieren den Pflegeaufwand der ohnehin schon zahlreichen Verbindungen. Die zeitliche Lücke ist damit nicht ein lösbares Detail, sondern eine inhärente Eigenschaft entkoppelter Systeme, die man nur verschieben, aber nicht beseitigen kann, solange die Daten in getrennten Beständen liegen.
Reporting-Bruch: Wenn die Auswertung an der Modulgrenze endet
Die vielleicht folgenreichste, weil strategisch teuerste Grenze zeigt sich nicht im operativen Tagesgeschäft, sondern in der Auswertbarkeit. Eine gekoppelte Landschaft besteht aus Systemen mit jeweils eigenem Datenmodell, eigenen Schlüsseln, eigenen Stammdaten und eigenen Definitionen. Ein Artikel kann im Webshop eine andere Nummer tragen als in der Warenwirtschaft, ein Kunde in zwei Systemen unterschiedlich geführt sein, ein Buchungsdatum anders interpretiert werden. Solange man innerhalb eines einzelnen Systems auswertet, fällt das nicht auf. Sobald jedoch eine Frage modulübergreifend beantwortet werden soll, bricht die Durchgängigkeit.
Fragen wie Welche Marge erzielen wir je Kunde unter Einbeziehung der tatsächlichen Lager- und Versandkosten? oder Wie entwickelt sich die Lagerreichweite je Artikel im Verhältnis zu den eingehenden Aufträgen? lassen sich in einer gekoppelten Welt nur beantworten, indem man Daten aus mehreren Systemen exportiert, manuell zusammenführt und über händisch gepflegte Zuordnungstabellen verknüpft. Genau an dieser Stelle entsteht der Reporting-Bruch: Die Auswertung ist nicht mehr ein Knopfdruck, sondern ein wiederkehrendes Datenprojekt, das von der korrekten Pflege der Zuordnungen abhängt und bei jeder Schnittstellenänderung neu validiert werden muss. Mit jeder zusätzlichen Quelle steigt die Wahrscheinlichkeit, dass Definitionen auseinanderlaufen und zwei Berichte zu derselben Frage unterschiedliche Zahlen liefern.
Dieser Bruch hat eine unmittelbare strategische Konsequenz: Die Unternehmensführung trifft Entscheidungen entweder auf verzögerter, manuell aufbereiteter Datengrundlage oder sie verzichtet ganz auf bestimmte Auswertungen, weil deren Erstellung zu aufwändig ist. Beides ist eine Wachstumsbremse, die sich nicht in der IT-Abteilung, sondern in der Qualität der Steuerung niederschlägt. Eine integrierte Warenwirtschaft als Programm innerhalb eines ERP umgeht diesen Bruch, weil alle Kennzahlen auf demselben Datenmodell mit denselben Schlüsseln beruhen und eine modulübergreifende Auswertung damit keine Datenfusion mehr erfordert, sondern lediglich eine Abfrage auf einem einzigen Bestand ist.
Konzeptionelle Schwellen: Mandanten, Standorte und Datenvolumen
Bis hierhin ging es um Symptome, die sich graduell verschlimmern. Daneben gibt es jedoch konzeptionelle Schwellen, an denen eine gekoppelte Standalone-Warenwirtschaft nicht nur langsamer, sondern strukturell ungeeignet wird. Diese Schwellen sind weniger eine Frage der Optimierung als eine Frage der grundsätzlichen Eignung der Architektur.
Die erste Schwelle ist die Mehrmandantenfähigkeit. Sobald ein Unternehmen mehrere rechtliche Einheiten, Tochtergesellschaften oder getrennt zu bilanzierende Geschäftsbereiche führt, muss jede Einheit ihre eigenen Bücher führen, gleichzeitig aber konsolidiert ausgewertet werden können. In einer gekoppelten Welt vervielfacht sich die Schnittstellenproblematik mit jedem Mandanten, weil die Verbindungen je Einheit neu hergestellt und zwischen den Einheiten zusätzlich koordiniert werden müssen. Eine für einen einzelnen Mandanten gebaute Standalone-Warenwirtschaft stößt hier an eine konzeptionelle Grenze, die sich durch noch so viele Schnittstellen nicht sauber überwinden lässt.
Die zweite Schwelle sind mehrere oder internationale Standorte. Mit verteilten Lagern, mehreren Ländern, unterschiedlichen Währungen, Steuerregimen und Sprachen entsteht ein Koordinationsbedarf, der eine zentrale, konsistente Datensicht voraussetzt. Bestandsübergreifende Verfügbarkeit über Standorte hinweg, standortübergreifende Umlagerungen und eine landesspezifische und zugleich konsolidierte Buchhaltung sind in einer entkoppelten Landschaft nur mit erheblichem und fehleranfälligem Schnittstellenaufwand abzubilden. Gerade für wachsende Unternehmen im Mittelstand markiert die Internationalisierung daher häufig den Punkt, an dem die gekoppelte Architektur ihre Tragfähigkeit verliert.
Die dritte Schwelle ist das schiere Datenvolumen und die Transaktionslast. Schnittstellen, die für einige hundert Belege pro Tag ausgelegt wurden, geraten bei einem Vielfachen dieser Last an ihre Leistungsgrenzen. Abgleichläufe dauern länger, Zeitfenster werden knapp, Fehlerwahrscheinlichkeiten steigen, und die ohnehin vorhandene Batch-Lücke weitet sich aus. Anders als bei den ersten beiden Schwellen handelt es sich hier nicht um eine Funktionsgrenze, sondern um eine Mengengrenze, aber das Ergebnis ist dasselbe: Die Kopplung wird vom unauffälligen Hilfsmittel zum kritischen Engpass.
Eine praktische Faustregel zur Selbstdiagnose fasst diese Schwellen zusammen: Wenn Diskussionen über Bestandsdifferenzen, nächtliche Läufe und die Frage Welche Zahl stimmt jetzt? regelmäßig Zeit der Führung binden, und wenn niemand mehr ein Update einspielen will, ohne vorher sämtliche Schnittstellen zu prüfen, dann ist die Skalierungsgrenze der gekoppelten Welt bereits erreicht. Diese Symptome sind keine Bedienungsfehler, sondern Eigenschaften der Architektur, und sie sind das verlässlichste Anzeichen dafür, dass eine der oben genannten Schwellen überschritten wurde.
Die Skalierungslogik im Überblick: Auslöser und Wirkung
Die einzelnen Grenzen wirken nicht isoliert, sondern verstärken sich gegenseitig. Mehr Systeme bedeuten mehr Schnittstellen, mehr Schnittstellen bedeuten mehr Versionsabhängigkeiten und mehr Batch-Lücken, und beides zusammen verschärft den Reporting-Bruch. Die folgende Tabelle ordnet die wichtigsten Wachstumspunkte ihren Auslösern und der jeweiligen Wirkung zu und macht damit sichtbar, dass es sich nicht um zufällige Störungen, sondern um eine systematische Skalierungslogik handelt.
| Wachstumspunkt | Auslöser | Wirkung in der gekoppelten Welt |
|---|---|---|
| Zusätzliches System | Neuer Webshop, neues CRM, neues Spezialwerkzeug | Quadratisch wachsende Zahl möglicher Verbindungen (n mal (n minus 1) geteilt durch zwei) |
| Update eines Endpunkts | Hersteller-Release, geändertes Datenmodell | Versions-Patt: Updates werden aus Angst vor Schnittstellenbruch aufgeschoben |
| Steigende Transaktionsfrequenz | Mehr Bestellungen, mehr Buchungen pro Stunde | Bestandsdifferenzen und Überverkauf im Batch-Zeitfenster |
| Modulübergreifende Auswertung | Frage nach Marge, Reichweite, Profitabilität je Kunde | Reporting-Bruch: manuelle Datenfusion, widersprüchliche Zahlen |
| Weiterer Mandant | Neue rechtliche Einheit, Tochtergesellschaft | Vervielfachung der Schnittstellen, konzeptionelle Eignungsgrenze |
| Internationaler Standort | Neues Land, Währung, Steuerregime, Sprache | Zentrale konsistente Datensicht über Schnittstellen kaum tragfähig |
| Wachsendes Datenvolumen | Vielfache Belegmenge gegenüber der Auslegung | Abgleichläufe überschreiten Zeitfenster, Kopplung wird Engpass |
Der gemeinsame Nenner aller Zeilen ist, dass die Probleme nicht aus einer mangelhaften Umsetzung einer einzelnen Schnittstelle stammen, sondern aus dem Prinzip der Kopplung selbst. Man kann eine einzelne Verbindung perfekt bauen und betreiben und steht trotzdem vor derselben Wand, sobald die Anzahl, die Frequenz oder das Volumen die jeweilige Schwelle überschreitet. Genau deshalb ist die Frage nach den Skalierungsgrenzen keine Detailfrage des Betriebs, sondern eine architektonische Grundsatzentscheidung.
Die strategische Schlussfolgerung dieses Abschnitts ist daher bewusst zurückhaltend formuliert: Die gekoppelte Welt ist nicht falsch, sondern hat einen klar umrissenen Gültigkeitsbereich. Solange die Zahl der Systeme klein, die Transaktionsfrequenz moderat, die Struktur einmandantig und national ist, kann eine über Schnittstellen gekoppelte Standalone-Warenwirtschaft die richtige, weil schlanke Wahl sein. Die hier beschriebenen Wachstumspunkte sind die Früh- und Spätwarnzeichen dafür, dass dieser Gültigkeitsbereich verlassen wird. Wer diese Zeichen kennt, kann den Übergang zu einer integrierten Lösung als bewusste Entscheidung zum richtigen Zeitpunkt treffen, statt von einer schleichend erstarrenden Landschaft dazu gezwungen zu werden. Wie dieser Übergang konkret gestaltet wird, ist Gegenstand des Migrationsabschnitts dieser Seite; die Aufgabe der vorliegenden Betrachtung war es allein, die Auslöser und die dahinterliegende Skalierungslogik klar zu benennen.